Как работать со стеком в ассемблере
Стек — это динамическая структура данных, которая позволяет сохранить важную информация о программе, включая локальные переменные, информацию о подпрограммах и временные данные. Процессор x86-64 управляет стеком через специальный регистр RSP (указатель стека). Когда программа начинает выполняться, операционная система инициализирует регистр RSP адресом последней ячейки памяти в сегменте стека.
Стек позволяет экономить использование регистров: мы можем сохранить временно данные в стеке, а регистры использовать непосредственно для вычислений. В то же время стоит помнить, что размер стека ограничен и на разных системах он занимает разное пространство. Так, на Linux х86-64 стек ограничен 2 мегабайтами.
В процессе работы программы данные записываются в сегмент стека или, наоборот, извлекаются из стека. Стек растет от больших адресов к меньшим, то есть при добавлении в стек данных, адрес добавляемых данных будет уменьшаться. Стоит отметить, что по умолчанию при начале работы программы стек выровнен по 16-байтовой границе, то есть адрес, который хранится в стеке кратен 16.
Для добавления данных в стек применяется инструкция push . В качестве единственного операнда инструкция принимает добавляемое в стек значение. Мы можем добавить в стек значения 16- и 64-разрядного регистра, адрес в памяти 16- и 64-разрядного числа или значение 16- и 32-разрядной константы (32-битная констранта расширяется до 64 бит).
При выполнении инструкции push от значения регистра RSP вычитается размер операнда. А по адресу, который хранится в стеке, помещается значение операнда.
rsp = rsp - размер операнда [rsp] = значение операнда
Инструкция pop позволяет, наоборот, взять из стека значение, адрес которого хранится в текущий момент в регистре RSP . Эта инструкция в качестве операнда получает место, куда надо сохранить данные из стека. Это может быть или 16- и 64-разрядный регистр или адрес в памяти 16- и 64-разрядного числа. При выполнении этой инструкции в операнд помещается значение, которое хранится в адресе из RSP. А само значение RSP увеличивается на размер операнда:
operand = [rsp] rsp = rsp + размер операнда
Например, возьмем следующую программу на Linux:
global _start section .text _start: mov rdx, 15 push rdx ; в стек помещаем содержимое регистра RDX pop rdi ; значение из вершины стека помещаем в регистр RDI mov rax, 60 syscall
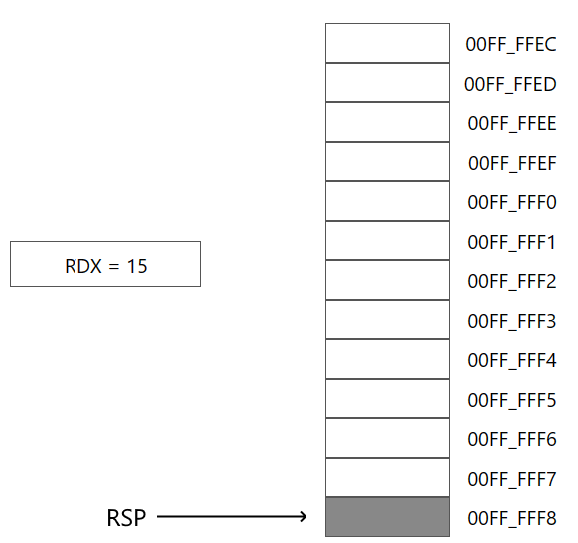
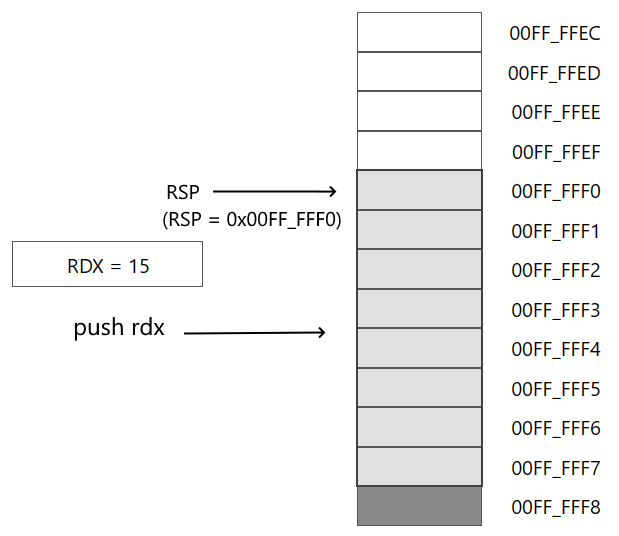
Допустим, регистр RSP содержит изначально адрес 0x00FF_FFF0. Пусть в регистре RDX хранится некоторое значение, которое с помощи инструкции pushq заталкивается в стек:
push rdx
В результате в последующие 8 байт начиная с адреса, который хранится в RSP, помещается значение из регистра RDX (в данном случае число 15). А в регистр RSP будет помещен адрес RSP-8, то есть условно 0x00FF_FFE8 и сохранит текущее значение регистра RDX в ячейках памяти начиная с 0x00FF_FFF0 по 0x00FF_FFE8, то есть займет 8 байт.
rsp -------------------------- 0x00FF_FFE8 push rdx -> | 15 | -------------------------------0x00FF_FFF0
Затем извлекаем из стека значение по адресу, который хранится в RSP, в регистр RDI:
pop rdi
В результате в RDI помещается число из стека (в данном случае число 15). А в регистр RSP будет помещен адрес RSP+8, то есть условно 00FF_FFF0h.
Аналогичная программа на Windows:
global _start section .text _start: mov rdx, 15 push rdx ; в стек помещаем содержимое регистра RDX pop rax ; значение из вершины стека помещаем в регистр RAX ret
Принцип LIFO и сохранение регистров в стек
Наиболее распространенное использование команд push и pop — это сохранение значений регистров во время промежуточных вычислений. Поскольку регистры — лучшее место для хранения временных значений, и регистры также могут потребоваться для других операций, поэтому в процессе программы легко исчерпать регистры. Инструкции push и pop позволяют сохранить начальные значения регистров при старте программы, а при завершении программы восстановить эти значения.
Следует учитывать, что стек представляет структуру LIFO (Last In, First Out или Последний вошел, первый вышел), что значит, что получение данных из стека происходит в порядке, обратном их добавлению. Рассмотрим следующую программу:
global _start section .text _start: mov rdi, 11 mov rdx, 33 push rdi push rdx pop rdi ; rdi = 33 pop rdx ; rdx = 11 mov rax, 60 syscall
Допустим, в самом начале программы до добавления данных стек регистр RSP хранит адрес 0x00FF_FFF0.
Затем добавляем в стек значение регистра RAX:
push rdi
Адрес в RSP смещается на 8 байтов и указывает на адрес в памяти, где хранится значение из регистра RDI
rsp = 0x00FF_FFE8 ------------------------------- -0x00FF_FFE0 | | rsp ---------------------------- 0x00FF_FFE8 push rdi -> | 11 | -------------------------------- 0x00FF_FFF0
Далее добавляем в стек значение регистра RDX:
push rdx
Адрес в RSP смещается на 8 байтов и указывает на адрес значения из регистра RDX
rsp = 0x00FF_FFE0 rsp--------------------------- 0x00FF_FFE0 push rdx -> | 33 | ------------------------------ 0x00FF_FFE8 | 11 | -------------------------------0x00FF_FFF0
После добавления мы последовательно извлекаем данные. Первая инструкция извлекает данные, на которые указывает регистр RSP, в регистр RDI:
pop rdi
rsp = 0x00FF_FFE8 ----------------------------- 0x00FF_FFE0 pop rdiОднако поскольку RSP перед операцией извлечения указывал на адрес последнего добавленного значения - значения регистра RDX, то регистр RDI получит значение регистра RDX. Соответственно при последующей инструкции pop:
pop rdxРегистр RDX получить значение регистра RDI, которое было в регистре RDI до добавления в стек.
rsp = 0x00FF_FFF0 ----------------------------- 0x00FF_FFE8 pop rdxПоэтому если мы хотим восстановить начальные значения регистров, то нам надо извлекать значения в порядке, обратном добавлению
push rdi push rdx pop rdx ; Последним добавлено значение RDX, поэтому сначала извлекаем в RDX pop rdiВ любом случае стоит помнить, что количество инструкций push и pop должно быть равно, сколько раз мы добавили данные в стек, столько раз мы должны получить данные из стека.
Сохранение флагов состояния
Ассемблер предоставляет дополнительную пару инструкций pushfq и popfq для сохранения и восстановления соответственно регистра RFLAGS (и всех флагов состояния). Например:
global _start section .text _start: pushfq ; сохраняем значения флагов mov al, 255 add al, 2 ; 255 + 2 = 257 - флаг CF будет установлен popfq ; восстанавливаем значения флагов jc set ; если флаг CF установлен, переход к метке set mov rdi, 11 jmp exit set: mov rdi, 22 exit: mov rax, 60 syscallЗдесь инструкцией pushfq сначала сохраняем флаги. По умолчанию флаг переноса CF будет равен 0.
Затем выполняем сложение 255 + 2, что даст 257 и что очевидно за пределы разрядности регистра AL, соответственно будет установлен флаг переноса CF. Далее с помощью инструкции jc set переходим к метке set, если флаг CF установлен. Однако перед этой инструкцией мы восстанавливаем флаги - popfq . То есть флаг CF получит свое значение 0, и никакого перехода к метке set не произойдет.
Восстановление стека без извлечения данных
При завершении программы следует восстановить адрес в RSP. Как выше было показано, для этого мы можем использовать инструкцию pop . Однако может сложиться ситуация, что данные не требуется извлекать из стека. Например, в зависимости от некоторых условий данные могут понадобиться, а могут не понадобиться. Если данные не нужны, извлекать каждые 8 байт отдельно с помощью инструкции pop не имеет смысла, особенно если надо извлечь много данных из стека. И в этом случае мы можем восстановить адрес в RSP, просто прибавив нужное значение - смещение относительно начального адреса. Например:
global _start section .text _start: mov rdi, 11 mov rdx, 33 push rdi push rdx add rsp, 16 ; прибавляем к адресу в RSP 16 байт mov rax, 60 syscallЗдесь в стек помещаем значения двух регистров - RDI и RDX, то есть адрес в RSP уменьшится на 16 байт (совокупный размер двух регистров). И чтобы быстро восстановить стек, прибавляем к адресу в RSP 16 байт:
add rsp, 16Подобным образом можно вычитать из адреса в RSP определенное число, тем самым резервируя в стеке некоторое пространство:
global _start section .text _start: sub rsp, 16 ; резервируем в стеке 16 байт ; некоторая работа со стеком add rsp, 16 ; восстанавливаем значение стека mov rax, 60 syscallПоскольку вначалае вычитаем из адреса в rsp 16 байт, то после работы со стеком к адресу в rsp также прибавляется 16 байт.
Косвенная адресация в стеке
Как и в случае с любым другим регистром, в отношении регистра стека RSP можно использовать косвенную адресацию и обращаться к данным в стеке без смещения указателя RSP. Например, следующая программа на Linux помещает в стек число из регистра rdx, а затем сохраняет это число из стека в регистр rdi:
global _start section .text _start: sub rsp, 16 ; резервируем в стеке 16 байт mov rdx, 11 mov [rsp], rdx ; помещаем в стек значение регистра RDX mov rdi, [rsp] ; в RDI помещаем значение по адресу из RSP - число 11 add rsp, 16 ; восстанавливаем значение стека mov rax, 60 syscallВ данном случае в стек помещаем число из регистра RDX - число 11.
mov [rsp], rdxПодобную форму размещения данных в стеке можно рассматривать как альтернативу инструкции push , если нам не надо изменять значение указателя стека RSP. То есть мы можем сохранить таким образом данные по адресу в RSP, но после этого RSP продолжает хранить тот же адрес.
Далее в регистр RDI помещаем значение, которое располагается по адресу из RSP. Фактически это тот адрес, где располагается число 11.
mov rdi, [rsp]Аналогичная программа на Windows:
global _start section .text _start: sub rsp, 16 ; резервируем в стеке 16 байт mov rdx, 11 mov [rsp], rdx ; помещаем в стек значение регистра RDX mov rax, [rsp] ; в RAX помещаем значение по адресу из RSP - число 11 add rsp, 16 ; восстанавливаем значение стека retАналогично можно применять смещения и масштабирование. Например, используем смещение в программе на Linux:
global _start section .text _start: push 12 push 13 push 14 push 15 mov rdi, [rsp+16] ; [rsp+16] - адрес значения 13 add rsp, 32 ; восстанавливаем значение стека mov rax, 60 syscallЗдесь в стек последовательно помещаются числа 12, 13, 14, 15. Каждое число будет занимать 8 байт. После добавления адрес в RSP будет указывать на адрес последнего добавленного числа - 15.
rsp = 0x00FF_FFD0 rsp----------------------- 0x00FF_FFD0 | 15 | -------------------------- 0x00FF_FFD8 | 14 | -------------------------- 0x00FF_FFE0 | 13 | -------------------------- 0x00FF_FFE8 | 12 | ---------------------------0x00FF_FFF0И чтобы, например, получить предыдущее число - 14, нам надо к адресу в RSP прибавить 8. А чтобы обратиться к числу 13, надо прибавить 16 байт:
mov rdi, [rsp+16]Соотвественно чтобы получить из стека первое число - 12, надо к адресу в RSP прибавить 24:
mov rdi, [rsp+24]Аналогичная программа на Windows:
global _start section .text _start: push 12 push 13 push 14 push 15 mov rax, [rsp+16] ; [rsp+16] - адрес значения 13 add rsp, 32 ; восстанавливаем значение стека retДругой пример (на Linux):
global _start section .text _start: sub rsp, 16 ; резервируем в стеке 16 байт mov rcx, 12 mov rdx, 13 mov [rsp + 8], rcx ; [rsp + 8] = 12 mov [rsp], rdx ; [rsp] = 13 mov rdi, [rsp] ; rdi= 13 add rdi, [rsp+8] ; rdi = rdi + 12 add rsp, 16 ; восстанавливаем значение стека mov rax, 60 syscallЗдесь по адресу RSP располагается значение региста RCX, а по адресу RSP+8 - регистра RDX. В RDI извлекаем значение по адресу RSP (13), и затем складываем его со значением из RSP+8 (12). Таким образом, в RDI будет число 25.
Аналогичный пример на Windows:
global _start section .text _start: sub rsp, 16 ; резервируем в стеке 16 байт mov rcx, 12 mov rdx, 13 mov [rsp + 8], rcx ; [rsp + 8] = 12 mov [rsp], rdx ; [rsp] = 13 mov rax, [rsp] ; rax= 13 add rax, [rsp+8] ; rax = rax + 12 add rsp, 16 ; восстанавливаем значение стека retMS-DOS и TASM 2.0. Часть 13. Стек.
Работа процедур тесно связана со стеком. Стеком называется область программы для временного хранения данных. Стек в ассемблере работает по правилу «Первым зашёл — последним вышел, последним зашёл — первым вышел». В любой период времени в стеке доступен только первый элемент, то есть элемент, загруженный в стек последним. Выгрузка из стека верхнего элемента делает доступным следующий элемент. Это напоминает ящик, в который поочерёдно ложатся книги. Чтобы получить доступ к книге, которую положили первой, необходимо достать поочерёдно все книги, лежащие сверху. Элементы стека располагаются в специально выделенной под стек области памяти, начиная со дна стека по последовательно уменьшающимся адресам. Адрес верхнего доступного элемента хранится в регистре-указателе стека SP. Стек может входить в какой-либо сегмент или быть отдельным сегментом. Сегментный адрес стека помещается в сегментный регистр SS. Пара регистров SS:SP образует адрес доступной ячейки стека.
Работа со стеком: команды PUSH и POP.
Работа со стеком осуществляется с помощью команд PUSH и POP.
PUSH (PUSH)
Затолкать операнд в стек:
push источник.
POP (POP)
Извлечь операнд из стека:
pop приемник.
Примеры для PUSH и POP:
Assembly (x86)
push cs ;значение cs можно затолкать в стек
pop ax ;а вот изменить значение cs нельзя (pop cs - ошибка)!«Заталкиваем» регистры в стэк:
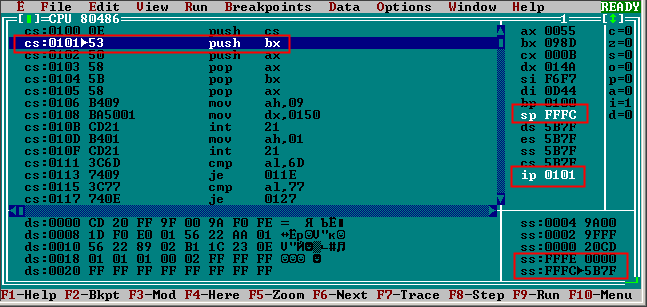
«Выталкиваем» регистры из стэка в обратной очерёдности:
Стек при работе с процедурой (функцией).
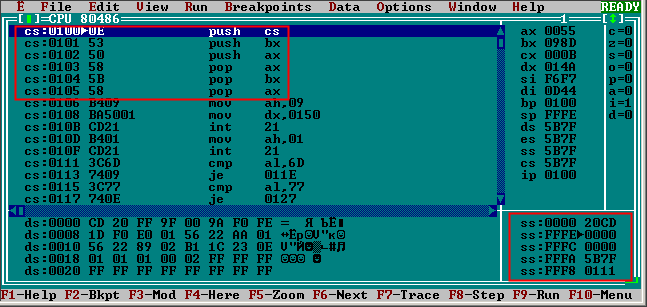
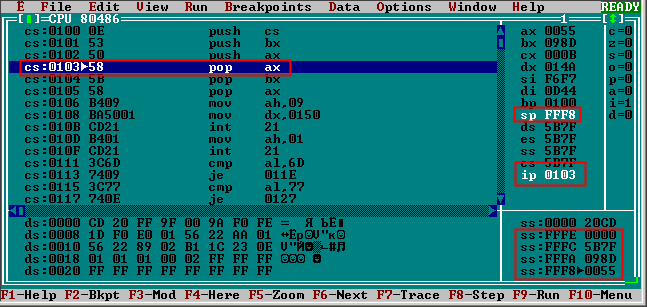
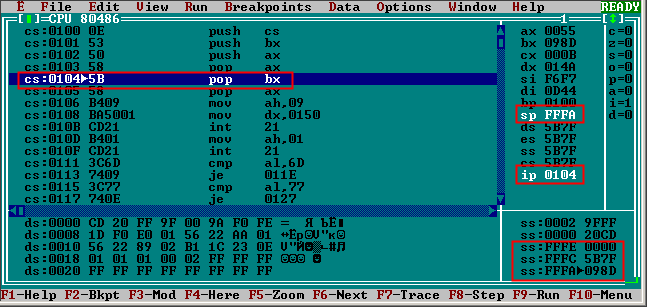
Теперь рассмотрим, как ведёт себя стек в ассемблере при работе с процедурой при использовании call и ret. Прогоним нашего «гоблина» через отладчик. Напомним, что IP — Указатель команд (Index Pointer). На каждом шаге выполнения программы указывает на адрес команды, следующей за исполняемой. Используем горячую клавишу F7 — Trace — пошаговое выполнение программы с заходом в циклы и процедуры.
…
cs:0113> call 0140;IP = 0113. Вызываем процедуру коммандой call 0140. В IP будет занесено значение указателя на нашу процедуру и она начнёт выполняться.
cs:0116> jmp 0100;
…После выхода из процедуры программа продолжит выполнение с IP = 0116. Стек (sp=FFFE): ss:FFFE>0000.
Что интересно, команду ret tasm транслировал в jmp. В данном случае ассемблер самостоятельно использовал оптимизацию кода в сторону ускорения быстродействия. В некоторых случаях такое «самоуправство» не приветствуется (написание «вирусного» кода и др.). Такими «болезнями» болеют все ассемблеры — кто-то больше, кто-то меньше. Знания прийдут вместе с опытом. Можно посоветовать всегда не лениться и пропускать исполняемый файл через отладчик.
Как работать со стеком в ассемблере
Стек — это динамическая структура данных, которая хранит важную информация о программе, включая локальные переменные, информацию о подпрограммах и временные данные. В архитектуре x86-64 стек реализуется с помощью сегмента стека. Процессор x86-64 управляет стеком через регистр RSP (указатель стека). Когда программа начинает выполняться, операционная система инициализирует регистр RSP адресом последней ячейки памяти в сегменте стека. В процессе работы программы данные записываются в сегмент стека или, наоборот, извлекаются из стека.
Стек растет от больших адресов к меньшим, то есть при добавлении в стек данных, адрес добавляемых данных будет уменьшаться. При запуске программы обычно стек выровнен по 8-байтовой границе. Например, RSP может хранить адрес 0x0000009BA9EFF9A8 (адрес оканчивается на 8).
Для добавления данных в стек применяется инструкция push , которая имеет следующий синтаксис:
push reg16 push reg64 push mem16 push mem64 pushw constant16 push constant32 ; расширяется до 64 битИтак, мы можем добавить в стек значения 16- и 64-разрядного регистра, 16- и 64-разрядной переменной и 16- и 32-разрядной константы (32-битная констранта расширяется до 64 бит).
При выполнении инструкции push от значения регистра RSP вычитается размер операнда. А по адресу, который хранится в стеке, помещается значение операнда.
RSP = RSP - размер операнда [RSP] = значение операндаИнструкция pop позволяет, наоборот, взять из стека значение, адрес которого хранится в текущий момент в регистре RSP . Эта инструкция имеет следующий синтаксис
pop reg16 pop reg64 pop memory16 pop memory64Инструкция в качестве операнда получает место, куда надо сохранить данные из стека. Это может быть или 16- и 64-разрядный регистр, или 16- и 64-разрядная переменная. При выполнении этой инструкции в операнд помещается значение, которое хранится в адресе из RSP. А само значение RSP увеличивается на размер операнда:
operand = [RSP] RSP = RSP + размер операндаНапример, возьмем следующую программу:
.code main proc mov rdx, 15 push rdx ; в конец стека помещаем содержимое регистра RDX pop rax ; значение из конца стека помещаем в регистр RAX ret main endp endДопустим, регистр RSP содержит изначально адрес 00FF_FFF8h.
Пусть в регистре RDX хранится некоторое значение, которое с помощи инструкции push заталкивается в стек:
push rdxВ результате в последующие 8 байт начиная с адреса, который хранится в RSP, помещается значение из регистра RDX (в данном случае число 15). А в регистр RSP будет помещен адрес RSP-8, то есть условно 00FF_FFF0h и сохранит текущее значение регистра RDX в ячейках памяти начиная с 00FF_FFF0h по 00FF_FFF7h, то есть займет 8 байт.
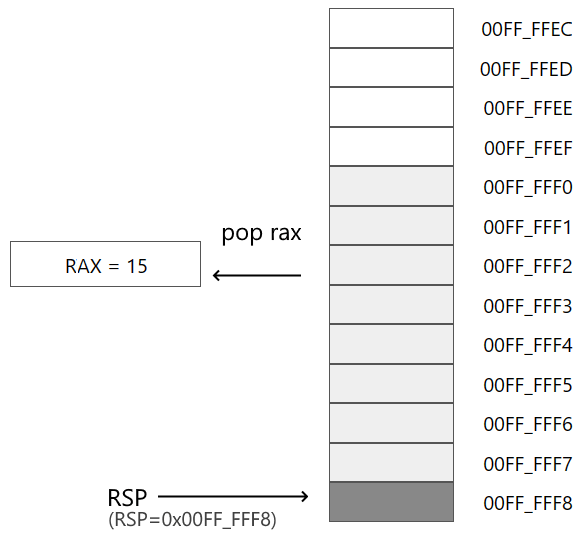
Затем извлекаем из стека значение по адресу, который хранится в RSP, в регистр RAX:
pop raxВ результате в RAX помещается число из стека (в данном случае число 15). А в регистр RSP будет помещен адрес RSP+8, то есть условно 00FF_FFF8h.
Принцип LIFO и сохранение регистров в стек
Наиболее распространенное использование команд push и pop — это сохранение значений регистров во время промежуточных вычислений. Поскольку регистры — лучшее место для хранения временных значений, и регистры также могут потребоваться для других операций, поэтому в процессе программы легко исчерпать регистры. Инструкции push и pop позволяют сохранить начальные значения регистров при старте программы, а при завершении программы восстановить эти значения.
Следует учитывать, что стек представляет структуру LIFO (Last In, First Out или Последний вошел, первый вышел), что значит, что получение данных из стека происходит в порядке, обратном их добавлению. Рассмотрим следующую программу:
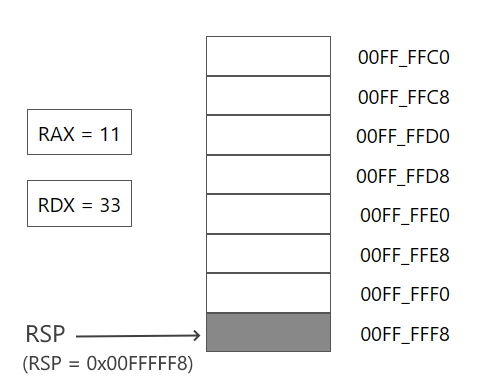
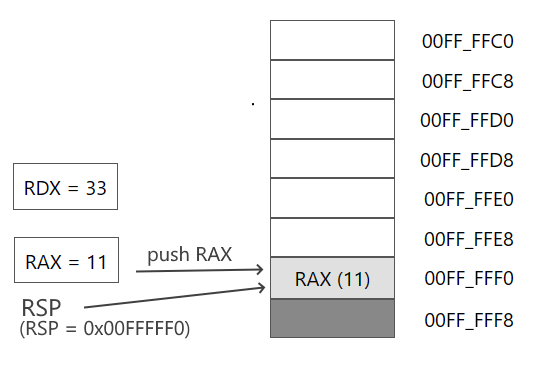
.code main proc mov rax, 11 mov rdx, 33 push rax push rdx pop rax pop rdx ret main endp endДопустим, в самом начале программы до добавления данных стек регистр RSP хранит адрес 00FF_FFF8.
Затем добавляем в стек значение регистра RAX:
push raxАдрес в RSP смещается на 8 байтов и указывает на адрес значения из регистра RAX
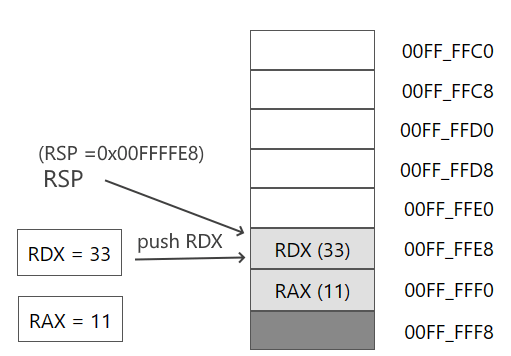
Далее добавляем в стек значение регистра RDX:
push rdxАдрес в RSP смещается на 8 байтов и указывает на адрес значения из регистра RDX
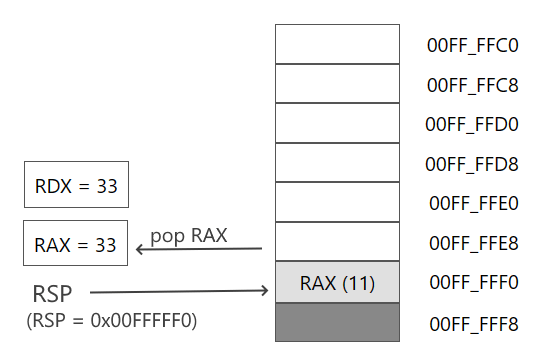
После добавления мы последовательно извлекаем данные. Первая инструкция извлекает данные, на которые указывает регистр RSP, в регистр RAX:
pop rax
Однако поскольку RSP перед операцией извлечения указывал на адрес последнего добавленного значения - значения регистра RDX, то регистр RAX получит значение регистра RDX. Соответственно при последующей инструкции pop:
pop rdxРегистр RDX получить значение регистра RAX, которое было в регистре RAX до добавления в стек.
Поэтому если мы хотим восстановить начальные значения регистров, то нам надо извлекать значения в порядке, обратном добавлению
push rax push rdx pop rdx ; Последним добавлено значение RDX, поэтому сначала извлекаем в RDX pop raxВ любом случае стоит помнить, что количество инструкций push и pop должно быть равно, сколько раз мы добавили данные в стек, столько раз мы должны получить данные из стека.
Сохранение флагов состояния
Ассемблер предоставляет дополнительную пару инструкций pushfq и popfq для сохранения и восстановления соответственно регистра RFLAGS (и всех флагов состояния). Например:
.code main proc pushfq ; сохраняем значения флагов mov al, 255 add al, 2 ; 255 + 2 = 257 - флаг CF будет установлен popfq ; восстанавливаем значения флагов jc set ; если флаг CF установлен, переход к метке set mov rax, 0 ret set: mov rax, 1 ret main endp endЗдесь инструкцией pushfq сначала сохраняем флаги. По умолчанию флаг переноса CF будет равен 0.
Затем выполняем сложение 255 + 2, что даст 257 и что очевидно за пределы разрядности регистра AL, соответственно будет установлен флаг переноса CF. Далее с помощью инструкции jc set переходим к метке set, если флаг CF установлен. Однако перед этой инструкцией мы восстанавливаем флаги - popfq . То есть флаг CF получит свое значение 0, и никакого перехода к метке set не произойдет.
Восстановление стека без извлечения данных
При завершении программы следует восстановить адрес в RSP. Как выше было показано, для этого мы можем использовать инструкцию pop . Однако может сложиться ситуация, что данные не требуется извлекать из стека. Например, в зависимости от некоторых условий данные могут понадобиться, а могут не понадобиться. Если данные не нужны, извлекать каждые 8 байт отдельно с помощью инструкции pop не имеет смысла, особенно если надо извлечь много данных из стека. И в этом случае мы можем восстановить адрес в RSP, просто прибавив нужное значение - смещение относительно начального адреса. Например:
.code main proc mov rax, 2 mov rdx, 3 push rax push rdx add rsp, 16 ; прибавляем к адресу в RSP 16 байт ret main endp endЗдесь в стек помещаем значения двух регистров - RAX и RDX, то есть адрес в RSP уменьшится на 16 байт (совокупный размер двух регистров). И чтобы быстро восстановить стек, прибавляем к адресу в RSP 16 байт:
add rsp, 16Подобным образом можно вычитать из адреса в RSP определенное число, тем самым резервируя в стеке некоторое пространство:
.code main proc sub rsp, 16 ; смещаем адрес в RSP на 16 байт mov rax, 2 add rsp, 16 ; восстанавливаем адрес в RSP ret main endp endВычитание определенного количество байтов из стека может потребоваться при взаимодействии с некоторыми внешними функциями, например, на языках C/С++ для резервирования места для параметров функций или для выравнивания стека. Так, до вызова функций в Windows в соответствии с Microsoft ABI стек должен быть выровнен по 16-байтовой границе. При использовании инструкции push для сохранения значения регистра перед вызовом внешней функции надо убедиться, адрес RSP кратен 16 байтам.
Косвенная адресация в стеке
Как и в случае с любым другим регистром, в отношении регистра стека RSP можно использовать косвенную адресацию и обращаться к данным в стеке без смещения указателя RSP. Например:
.code main proc sub rsp, 16 ; резервируем в стеке 16 байт mov rdx, 11 mov [rsp], rdx ; помещаем в стек значение регистра RDX mov rax, [rsp] ; в RAX помещаем значение по адресу из RSP - число 11 add rsp, 16 ; восстанавливаем указатель стека ret main endp endВ данном случае в стек помещаем число из регистра RDX - число 11.
mov [rsp], rdxПодобную форму размещения данных в стеке можно рассматривать как альтернативу инструкции push , если нам не надо изменять значение указателя стека RSP. То есть мы можем сохранить таким образом данные по адресу в RSP, но после этого RSP продолжает хранить тот же адрес.
Далее в регистр RAX помещаем значение, которое располагается по адресу из RSP. Фактически это тот адрес, где располагается число 11.
mov rax, [rsp]Аналогично можно применять смещения и масштабирование. Например:
.code main proc push 12 push 13 push 14 mov rax, [rsp + 8] ; [rsp + 8] - адрес значения 13 ; извлекаем сохраненные значения в r8, r9, r10 pop r8 pop r9 pop r10 ret main endp endЗдесь в стек последовательно помещаются три числа 12, 13, 14. Каждое число будет занимать 8 байт. После добавления адрес в RSP будет указывать на адрес последнего добавленного числа - 14. И чтобы, например, получить предыдущее число - 13, нам надо к адресу в RSP прибавить 8. И в данном случае получаем это число в регистр RAX.
mov rax, [rsp + 8]Соотвественно чтобы получить из стека первое число - 12, надо к адресу в RSP прибавить 16:
mov rax, [rsp + 16].code main proc sub rsp, 16 ; резервируем в стеке 16 байт mov rbx, 12 mov rdx, 13 mov [rsp], rbx ; помещаем значение из RBX по адресу RSP mov [rsp+8], rdx ; помещаем значение из RDX по адресу RSP+8 mov rax, [rsp] ; в RAX помещаем значение по адресу из RSP add rax, [rsp+8] ; складываем с числом из RSP+8 add rsp, 16 ; восстанавливаем данные из стека ret main endp endЗдесь по адресу RSP располагается значение региста RBX, а по адресу RSP+8 - регистра RDX. В RAX извлекаем значение по адресу RSP (12), и затем складываем его со значением из RSP+8 (13). Таким образом, в RAX будет число 25.
Ограничения места в стеке
По умолчанию данные в стеке занимают то место, которое соответствует размеру регистра. Так, инструкция mov [rsp], rbx помещала в стек 8 байт из RBX. То есть данные в стеке занимали 8 байт. Однако в примере выше в RBX хранится число, для которого достаточно и 1 байта, для него не требуется аж 8 байт. Пространство в стеке расходуется не экономично. В этом случае с помощью преобразования данных мы можем явным образом указать, сколько байтов мы хотим использовать в стеке
.code main proc sub rsp, 16 ; резервируем в стеке 16 байт mov rbx, 11 mov rdx, 12 mov [rsp], bl ; помещаем байт из BL по адресу RSP mov [rsp+1], dl ; помещаем байт из DL по адресу RSP+1 movzx rax, byte ptr [rsp] ; в AL помещаем значение по адресу из RSP add al, byte ptr [rsp+1] ; складываем с числом из RSP+1 add rsp, 16 ; восстанавливаем данные из стека ret main endp endЗдесь в RAX извлекаем только один байт:
movzx rax, byte ptr [rsp]Затем добавляем в AL еще один байт из стека, который хранится по адресу RSP+1:
add al, byte ptr [rsp+1]Преобразования данных могут быть особенно актуальны, если необходимо поместить в стек непосредственный операнд:
.code main proc sub rsp, 16 ; резервируем в стеке 16 байт mov qword ptr [rsp], 11 ; в стек помещаем число 11 - оно занимает 8 байт mov word ptr [rsp+8], 15 ; по адресу в RSP+8 помещаем 2-байтное число 15 mov rax, qword ptr [rsp] ; RAX = 11 add ax, word ptr [rsp+8] ; складываем с числом из RSP+8 add rsp, 16 ; восстанавливаем данные из стека ret main endp endЗдесь сначала помещаем в стек число 11, которое будет занисать 8 байт, так как мы приводим к типу qword:
mov qword ptr [rsp], 11Затем по адресу RSP+2 помещаем число 15, которое будет занимать 2 байта:
mov word ptr [rsp+8], 15Затем извлекаем эти данные и складываем их:
mov rax, qword ptr [rsp] ; RAX = 11 add ax, word ptr [rsp+8] ; складываем с числом из RSP+8Стоит обратить внимание, что тип извлекаемых данных соответствует размеру регистра, либо при извлечение 1 байта применется операция расширения movzx/movsx . Некорректное извлечение может привести к некорректным результатам:
.code main proc sub rsp, 16 ; резервируем в стеке 16 байт mov byte ptr [rsp], 10 ; по адресу в RSP помещаем число 10 mov byte ptr [rsp+1], 11 ; по адресу в RSP+1 помещаем число 11 mov rax, [rsp] ; RAX = ? add rsp, 16 ; восстанавливаем данные из стека ret main endp endЗдесь в стек последовательно помещаем два байта - числа 10 и 11. Затем извлекам из стека данные. Но обратите внимание как идет извлечение
mov rax, [rsp] ; RAX = ?Какое число окажется в регистре RAX? Здесь в регистр RAX из стека скопируются 8 байт, из которых первые два байта - это числа 10 и 11, остальные 6 байт неопределены. Соответственно результат в RAX неопределен. И чтобы взять только нужную нам порцию данных, следует использовать преобразование типов:
.code main proc sub rsp, 16 ; резервируем в стеке 16 байт mov byte ptr [rsp], 10 ; по адресу в RSP помещаем число 10 mov byte ptr [rsp+1], 11 ; по адресу в RSP+1 помещаем число 11 movzx rax, byte ptr [rsp] ; RAX = 10 add rsp, 16 ; восстанавливаем данные из стека ret main endp endРасположение данных в стеке
Может возникнуть вопрос, как числа размером более одного байта сохраняются в стеке? Рассмотрим следующую программу:
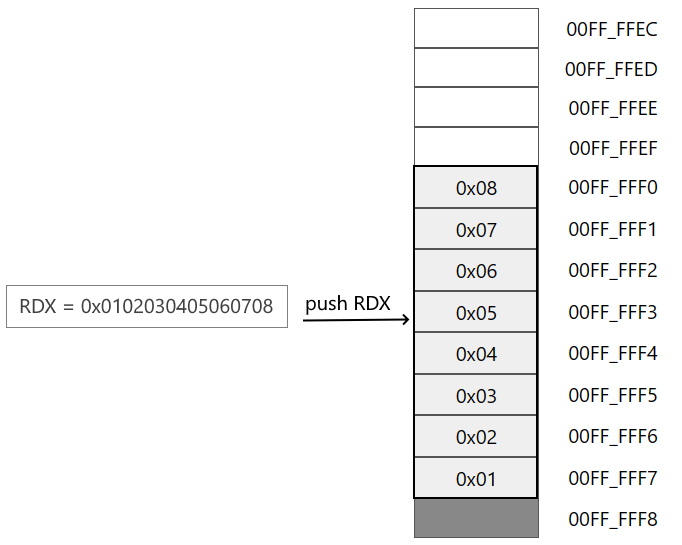
.code main proc mov rdx, 0102030405060708h ; в RDX 8-байтное число push rdx ; сохраняем число из RDX в стек movzx rax, byte ptr [rsp] ; в RAX сохраняем 1 байт по адресу в RSP pop rdx ; извлекаем число из стека в RDX ret main endp endЗдесь в регистр RDX сохраняем 16-ричное число 0x0102030405060708 . Далее это число помещаем в стек.
Затем с помощью инструкции movzx помещаем в RAX 1 байт, извлеченный из стека по адресу который хранится в RSP. Чему будет равен этот байт - 0, 1 или 8?
При добавлении в стек старшие биты числа располагаются по старшим адресам, а младшие биты по младшим адресам:
Соответственно в регистре RAX окажется число 0х08
Аналогично, если мы хотим получить старший байт 8-битного числа, то мы можем сместиться относительно адреса RSP вниз на 7 байт (то есть RSP+7):
movzx rax, byte ptr [rsp+7] ; RAX = 0x01Assembler
Стеком называют область программы для временного хранения произвольных данных. Разумеется, данные можно сохранять и в сегменте данных, однако в этом случае для каждого сохраняемого на время данного надо заводить отдельную именованную ячейку памяти, что увеличивает размер программы и количество используемых имен. Удобство стека заключается в том, что его область используется многократно, причем сохранение в стеке данных и выборка их оттуда выполняется с помощью эффективных команд push и pop без указания каких-либо имен.
Стек традиционно используется, например, для сохранения содержимого регистров, используемых программой, перед вызовом подпрограммы, которая, в свою очередь, будет использовать регистры процессора "в своих личных целях". Исходное содержимое регистров извлекается из стека после возврата из подпрограммы. Другой распространенный прием - передача подпрограмме требуемых ею параметров через стек. Подпрограмма, зная, в каком порядке помещены в стек параметры, может забрать их оттуда и использовать при своем выполнении.
Отличительной особенностью стека является своеобразный порядок выборки содержащихся в нем данных: в любой момент времени в стеке доступен только верхний элемент, т.е. элемент, загруженный в стек последним . Выгрузка из стека верхнего элемента делает доступным следующий элемент.
Элементы стека располагаются в области памяти, отведенной под стек, начиная со дна стека (т.е. с его максимального адреса) по последовательно уменьшающимся адресам. Адрес верхнего, доступного элемента хранится в регистре-указателе стека SP. Как и любая другая область памяти программы, стек должен входить в какой-то сегмент или образовывать отдельный сегмент. В любом случае сегментный адрес этого сегмента помещается в сегментный регистр стека SS. Таким образом, пара регистров SS:SP описывают адрес доступной ячейки стека: в SS хранится сегментный адрес стека, а в SP - смещение последнего сохраненного в стеке данного (смотрим рисунок). Обратите внимание на то, что в исходном состоянии указатель стека SP указывает на ячейку, лежащую под дном стека и не входящую в него .
а - исходное состояние, б - после загрузки одного элемента (в данном примере - содержимого регистра АХ), в - после загрузки второго элемента (содержимого регистра DS), г - после выгрузки одного элемента, д - после выгрузки двух элементов и возврата в исходное состояние.
Загрузка в стек осуществляется специальной командой работы со стеком push (протолкнуть). Эта команда сначала уменьшает на 2 содержимое указателя стека (SP), а затем помещает операнд по адресу в SP. Если, например, мы хотим временно сохранить в стеке содержимое регистра АХ, следует выполнить команду
Стек переходит в состояние, показанное на рис. б. Видно, что указатель стека смещается на два байта вверх (в сторону меньших адресов) и по этому адресу записывается указанный в команде проталкивания операнд. Следующая команда загрузки в стек, например,
переведет стек в состояние, показанное на рис. в. В стеке будут теперь храниться два элемента, причем доступным будет только верхний, на который указывает указатель стека SP. Если спустя какое-то время нам понадобилось восстановить исходное содержимое сохраненных в стеке регистров, мы должны выполнить команды выгрузки из стека pop (вытолкнуть):
Состояние стека после выполнения первой команды показано на рис. г, а после второй - на рис. д. Для правильного восстановления содержимого регистров выгрузка из стека должна выполняться в порядке, строго противоположном загрузке - сначала выгружается элемент, загруженный последним, затем предыдущий элемент и т.д.
Совсем не обязательно при восстановлении данных помещать их туда, где они были перед сохранением. Например, можно поместить в стек содержимое DS, а извлечь его оттуда в другой сегментный регистр - ES;push DS
pop ES ; Теперь ES=DS, а стек пустЭто распространенный прием для перенесения содержимого одного регистра в другой, особенно, если второй регистр - сегментный.
Обратите внимание (см. рисунок) на то, что после выгрузки сохраненных в стеке данных они физически не стерлись, а остались в области стека на своих местах. Правда, при "стандартной" работе со стеком они оказываются недоступными. Действительно, поскольку указатель стека SP указывает под дно стека, стек считается пустым; очередная команда push поместит новое данное на место сохраненного ранее содержимого АХ, затерев его. Однако пока стек физически не затерт, сохраненными и уже выбранными из него данными можно пользоваться, если помнить, в каком порядке они расположены в стеке. Этот прием часто используется при работе с подпрограммами.
Какого размера должен быть стек? Это зависит от того, насколько интенсивно он используется в программе. Если, например, планируется хранить в стеке массив объемом 10 000 байт, то стек должен быть не меньше этого размера. При этом надо иметь в виду, что в ряде случаев стек автоматически используется системой, в частности, при выполнении команды прерывания int 21h. По этой команде сначала процессор помещает в стек адрес возврата, а затем DOS отправляет туда же содержимое регистров и другую информацию, относящуюся к прерванной программе. Поэтому, даже если программа совсем не использует стек, он все же должен присутствовать в программе и иметь размер не менее нескольких десятков слов.
Что произойдет, если программист по ошибке или умышленно не опишет стек в своей программе? Изменим нашу мега программу, удалив из нее описание стека.
В регистр DX помещен код двух знаков @ . Это сделано для наглядности примера.
Запустим программу под отладчиком.
Видим, что в SS находится тот же адрес , что и в CS ; от сюда можно сделать вывод, что сегменты команд и стека совпадают. Однако содержимое SP равно нулю. Первая же команда push уменьшит содержимое SP на 2, то есть поместит в SP число -2, значит ли это, что стек будет расти как ему и положено, ввех, но не внутри сегмента команд, а над ним, по адресам -2, -4, -6 и т.д. относительно верхней границы сегмента команд. Оказывается это не так.
Если взять 16-разрядный двоичный счетчик, в котором записн 0, и послать в него два вычитающих импульса, то после первого в нем окажется число FFFFh, а после второго – FFFE h. При желании мы можем рассматривать число FFFEh как -2 (что имеет место при работе со знаковыми числами, о которых поговорим чуть позже), однако процессор при вычислении адресов рассматривает содержимое регистров как целые числа без знака и число FFFE h оказывается эквивалентным не -2, а 65534 . В результате первая же команда занесения данного в стек (в нашем случае push dx) поместит это данное не над сегментом команд, а в самый его конец, в последнее слово по адресу CS:FFFE h (что, в данном примере, эквивалентно SS:FFFEh). При дальнейшем использовании стека его указатель будет смещаться в сторону меньших адресов, проходя значения FFFCh, FFFAh и т.д.
Таким образом, если в программе отсутствует явное определение стека, система сама создает стек по умолчанию в конце сегмента команд или, точнее, по адресу FFFEh относительно начала сегмента команд (см. рисунок).
Выполним программу дальше и убедимся в этом. По ходу выполнения программы с первой команды до седьмой, мы сможем видеть, что в стек помещаются какие-то значения, но при этом регистр SP не изменяется (предположительно, все это самодеятельность отладчика), и только после выполнения седьмой команды – push dx , SP принимает значение FFFE h, и на дне стека мы видим два символа @ .
Рассмотренное явление , когда при уменьшении адреса после адреса 0 у нас получается адрес FFFE h, т.е. от начала сегмента мы прыгнули сразу в его конец, носит название циклического возврата или оборачивания адреса . С этим явлением приходится сталкиваться довольно часто.
Расположение стека в конце сегмента команд не приводит к каким-либо неприятностям, пока размер программы далек от граничной величины 64Кбайт. В этом случае начало сегмента команд занимают коды команд, конец – стек, а между ними располагаются данные (если сегмент данных описан в программе после сегмента команд). Если, однако, размер сегментов команд или данных приближается к 64Кбайт, то фактически стек будет наложен на тот или иной сегмент программы и возникнет опасность затирания данных или кода. Очевидно, что этого нельзя допускать. В тоже время, система не проверяет, что происходит со стеком и ни как не реагирует на затирание команд или данных. Таким образом, оценка размеров собственно программы, данных и стека является важным этапом разработки программы.