Как работает быстрая сортировка c
Сегодня расскажем об одном из самых эффективных и широко применяемых на практике алгоритмов сортировки — быстрой сортировке, или Quick Sort, или qsort. Этот алгоритм был разработан более 40 лет назад, отчасти поэтому на практике в чистом виде он не встречается, так как уже есть способы добиться наибольшей эффективности при работе этого алгоритма.
Чтобы понимать, как и зачем этот алгоритм улучшается, нужно разобраться, как он работает в своём первозданном виде. Важно отметить, что для своей вычислительной эффективности этот алгоритм достаточно прост в понимании и реализации.
Алгоритм работает по принципу «разделяй и властвуй» — мы будем разделять массив и применять один и тот же алгоритм к его всё уменьшающимся частям. Общая схема алгоритма выглядит так:
- Из массива выбирается элемент, который называется pivot, т. е. опорный элемент.
- Далее запускается процедура разделения массива таким образом, чтобы в одной его части находились все элементы, которые меньше или равны опорному элементу, а во второй части — все элементы, которые больше опорного элемента.
- Для каждого подмассива, если в них больше двух элементов, рекурсивно запускается процедура, описанная в предыдущем пункте. Если элемента два, то они сравниваются друг с другом и при необходимости меняются местами.
После выполнения этих действий мы получим полностью отсортированный массив.
Рассмотрим подробнее второй пункт, что же там происходит. Для этого возьмём неотсортированный массив элементов [7, 2, 1, 8, 6, 3, 5, 4] и пройдёмся по шагам.
Шаг 1
Для начала выберем опорный элемент — возьмём последний элемент массива, он равен 4. Также введём два счётчика — i и j. Будем считать, что индексация в массиве начинается с 0. Тогда i = -1, а j = 0.
Сравниваем j-й элемент массива [7] с опорным элементом [4]. Если j-й элемент больше опорного, то просто инкрементируем счётчик j. В нашем случае на первом шаге мы так и сделаем.
Теперь j = 1, сравниваем j-й элемент массива [2] с опорным элементом [4]. Если он меньше опорного, то инкрементируем счётчик. Теперь i = 0, и меняем местами i-й и j-й элементы массива. В нашем случае меняем местами нулевой и первый элементы массива, получаем массив [2, 7, 1, 8, 6, 3, 5], опорный элемент [4] и инкрементируем счётчик j.
Далее шаг за шагом продвигаемся по массиву.
Шаг 2
Счетчик j = 2, сравниваем [1] и [4]. В этом случае инкрементируем i, i = 1 далее меняем местами i-й и j-й элементы массива [7] и [1], получаем массив [2, 1, 7, 8, 6, 3, 5], опорный элемент [4] и инкрементируем счётчик j.
Шаг 3
Счетчик j = 3, сравниваем [8] и [4]. В этом случае инкрементируем только счётчик j.
Шаг 4
Счётчик j = 4, сравниваем [6] и [4]. В этом случае инкрементируем только счётчик j.
Шаг 5
Счётчик j = 5, сравниваем [3] и [4]. В этом случае инкрементируем i, i = 2 и меняем местами i-й и j-й элементы массива [7] и [3], получаем массив [2, 1, 3, 8, 6, 7, 5], опорный элемент [4] и инкрементируем счётчик j.
Шаг 6
Счётчик j = 6, сравниваем [5] и [4]. Счётчик j можно не инкрементировать, так как мы добрались до конца массива.
Далее вышеописанные действия повторяются для каждого из подмассивов до тех пор, пока массив не будет полностью отсортирован.
По этим шагам несложно реализовать алгоритм в коде.
Особенности алгоритма
Теперь поговорим о нюансах. Первый и вполне справедливый вопрос, почему мы выбрали опорный элемент именно так? Ответ прост: потому что так проще. Выбор опорного элемента — задача не из лёгких. То, насколько правильно он выбран, напрямую влияет на вычислительную сложность.
Пример выбора опорного элемента: взять первый, последний и средний элементы массива, отсортировать их и взять тот, что посередине. Таким простым действием можно улучшить качество выбранного опорного элемента.
Преимущества и недостатки алгоритма
Что касается сложности быстрой сортировки, то в лучшем случае мы получим сложность Ω (n log n), а в худшем — O(n 2 ). Кроме низкой вычислительной сложности этот алгоритм обладает и другими достоинствами:
- на практике это один из самых быстродействующих алгоритмов внутренней сортировки;
- алгоритм довольно простой как для понимания, так и для реализации;
- требует лишь O(n) памяти, в случае улучшенной версии — O(1);
- допускает естественное распараллеливание для сортировки подмассивов;
- работает на связных списках;
- является наиболее эффективным для сортировки большого количества данных.
К недостаткам можно отнести:
- неустойчивость;
- вычислительная сложность сильно деградирует при неудачных входных данных.
Этот алгоритм, пусть и с модификациями, используется в различных языках программирования. Например, в Java его реализацию можно встретить в библиотеке java.util.Arrays, в методе sort(). А вот что написано в документации Oracle: “Реализация: в качестве алгоритма используется Dual-Pivot Quick Sort, разработанный Владимиром Ярославским, Джоном Бэнтли и Джошуа Блохом”. Поэтому этот алгоритм определённо достоин вашего внимания.
Ещё больше сортировок вы найдёте здесь:
- Разбираем пирамидальную сортировку.
- Разбираем сортировку Шелла.
- Разбираем простые сортировки. Пузырьковая сортировка.
- Разбираем простые сортировки на примерах.
Быстрая сортировка
Всем привет. Сегодня продолжаем серию статей, которые я написал специально к запуску курса «Алгоритмы и структуры данных» от OTUS. По ссылке вы сможете подробно узнать о курсе, а также бесплатно посмотреть запись Demo-урока по теме: «Три алгоритма поиска шаблона в тексте».
Введение
Сортировка массива является одной из первых серьезных задач, изучаемых в классическом курсе «Алгоритмы и структуры данных» дисциплины computer science. В связи с этим задачи на написание сортировок и соответствующие вопросы часто встречаются на собеседованиях на позиции стажера или junior разработчика.
Постановка задачи
Традиционно стоит начать изложение решений задачи с ее постановки. Обычно задача сортировки предполагает упорядочивание некоторого массива целых чисел по возрастанию. Но на самом деле, это является некоторым упрощением. Излагаемые в этом разделе алгоритмы можно применять для упорядочивания массива любых объектов, между которыми установлено отношение порядка (то есть про любые два элемента можно сказать: первый больше второго, второй больше первого или они равны). Упорядочивать можно как по возрастанию, так и по убыванию. Мы же воспользуемся стандартным упрощением.
Быстрая сортировка
В прошлый раз мы поговорили о чуть более сложной сортировке — сортировке вставками. Сегодня речь пойдет о существенно более сложном алгоритме — быстрой сортировке (еще ее называют сортировкой Хоара).
Описание алгоритма
Алгоритм быстрой сортировки является рекурсивным, поэтому для простоты процедура на вход будет принимать границы участка массива от l включительно и до r не включительно. Понятно, что для того, чтобы отсортировать весь массив, в качестве параметра l надо передать 0, а в качестве r — n, где по традиции n обозначает длину массива.
В основе алгоритма быстрой сортировке лежит процедура partition. Partition выбирает некоторый элемент массива и переставляет элементы участка массива таким образом, чтобы массив разбился на 2 части: левая часть содержит элементы, которые меньше этого элемента, а правая часть содержит элементы, которые больше или равны этого элемента. Такой разделяющий элемент называется пивотом.
partition(l, r): pivot = a[random(l . r - 1)] m = l for i = l . r - 1: if a[i] < pivot: swap(a[i], a[m]) m++ return m Пивот в нашем случае выбирается случайным образом. Такой алгоритм называется рандомизированным. На самом деле пивот можно выбирать самым разным образом: либо брать случайный элемент, либо брать первый / последний элемент учаcтка, либо выбирать его каким-то «умным» образом. Выбор пивота является очень важным для итоговой сложности алгоритма сортировки, но об этом несколько позже. Сложность же процедуры partition — O(n), где n = r — l — длина участка.
Теперь используем partition для реализации сортировки:
sort(l, r): if r - l = 1: return m = partition(l, r) sort(l, m) sort(m, r) Крайний случай — массив из одного элемента обладает свойством упорядоченности. Если массив длинный, то применяем partition и вызываем процедуру рекурсивно для двух половин массива.
Если прогнать написанную сортировку на примере массива 1 2 2, то можно заметить, что она никогда не закончится. Почему так получилось?
При написании partition мы сделали допущение — все элементы массива должны быть уникальны. В противном случае возвращаемое значение m будет равно l и рекурсия никогда не закончится, потому как sort(l, m) будет вызывать sort(l, l) и sort(l, m). Для решения данной проблемы надо массив разделять не на 2 части (< pivot и >= pivot), а на 3 части ( < pivot, = pivot, >pivot) и вызывать рекурсивно сортировку для 1-ой и 3-ей частей.
Анализ
Предлагаю проанализировать данный алгоритм.
Временная сложность алгоритма выражается через нее же по формуле: T(n) = n + T(a * n) + T((1 — a) * n). Таким образом, когда мы вызываем сортировку массива из n элементов, тратится порядка n операций на выполнение partition'а и на выполнения себя же 2 раза с параметрами a * n и (1 — a) * n, потому что пивот разделил элемент на доли.
В лучшем случае a = 1 / 2, то есть пивот каждый раз делит участок на две равные части. В таком случае: T(n) = n + 2 * T(n / 2) = n + 2 * (n / 2 + 2 * T(n / 4)) = n + n + 4 * T(n / 4) = n + n + 4 * (n / 4 + 2 * T(n / 8)) = n + n + n + 8 * T(n / 8) =…. Итого будет log(n) слагаемых, потому как слагаемые появляются до тех пор, пока аргумент не уменьшится до 1. В результате T(n) = O(n * log(n)).
В худшем случае a = 1 / n, то есть пивот отсекает ровно один элемент. В первой части массива находится 1 элемент, а во второй n — 1. То есть: T(n) =n + T(1) + T(n — 1) = n + O(1) + T(n — 1) = n + O(1) + (n — 1 + O(1) + T(n — 2)) = O(n^2). Квадрат возникает из-за того, что он фигурирует в формуле суммы арифметической прогрессии, которая появляется в процессе расписывания формулы.
В среднем в идеале надо считать математическое ожидание различных вариантов. Можно показать, что если пивот делит массив в отношении 1:9, то итоговая асимптотика будет все равно O(n * log(n)).
Сортировка называется быстрой, потому что константа, которая скрывается под знаком O на практике оказывается достаточно небольшой, что привело к широкому распространению алгоритма на практике.
Читать ещё
- Сортировка вставками
- Удаление узлов из красно-чёрного дерева
Быстрая сортировка и с чем её едят
Всем привет! Я расскажу об алгоритме быстрой сортировки и покажу, как его можно реализовать программно.
Итак, быстрая сортировка, или, по названию функции в Си, Qsort — это алгоритм сортировки, сложность которого в среднем составляет O(n log(n)). Суть его предельно проста: выбирается так называемый опорный элемент, и массив делится на 3 подмассива: меньших опорного, равных опорному и больших опорного. Потом этот алгоритм применяется рекурсивно к подмассивам.
Алгоритм
- Выбираем опорный элемент
- Разбиваем массив на 3 части
- Создаём переменные l и r — индексы соответственно начала и конца рассматриваемого подмассива
- Увеличиваем l, пока l-й элемент меньше опорного
- Уменьшаем r, пока r-й элемент больше опорного
- Если l всё ещё меньше r, то меняем l-й и r-й элементы местами, инкрементируем l и декрементируем r
- Если l вдруг становится больше r, то прерываем цикл
- Повторяем рекурсивно, пока не дойдём до массива из 1 элемента
// qsort (0, n-1);
* This source code was highlighted with Source Code Highlighter .
Эта реализация имеет ряд недостатков, таких как возможное переполнение стека из-за большого количества вложенной рекурсии и то, что опорным элементом всегда берётся средний. Для примера это, может, и нормально, но при решении, например, олимпиадных задач, хитрое жюри может специально подобрать такие тесты, чтобы на них это решение работало слишком долго и не проходило в лимит. В принципе, в качестве опорного элемента можно брать любой, но лучше, чтобы он был максимально приближен к медиане, поэтому можно выбрать его случайно или взять средний по значению из первого, среднего и последнего. Зависимость быстродействия от опорного элемента — один из недостатков алгоритма, ничего с этим не поделать, но сильная деградация производительности происходит редко, обычно если сортируется специально подобранный набор чисел. Если всё-таки нужна сортировка, работающая гарантированно быстро, можно использовать, например, пирамидальную сортировку, всегда работающую строго за O(n log n). Обычно Qsort всё же выигрывает в производительности перед другими сортировками, не требует много дополнительной памяти и достаточно прост в реализации, поэтому пользуется заслуженной популярностью.
Быстрая сортировка
Быстрая сортировка (англ. quick sort, сортировка Хоара) — один из самых известных и широко используемых алгоритмов сортировки. Среднее время работы [math]O(n\log)[/math] , что является асимптотически оптимальным временем работы для алгоритма, основанного на сравнении. Хотя время работы алгоритма для массива из [math]n[/math] элементов в худшем случае может составить [math]\Theta(n^2)[/math] , на практике этот алгоритм является одним из самых быстрых.
Алгоритм
Быстрый метод сортировки функционирует по принципу "разделяй и властвуй".
- Массив [math] a[l \ldots r][/math] типа [math] T [/math] разбивается на два (возможно пустых) подмассива [math] a[l \ldots q][/math] и [math] a[q+1 \ldots r][/math] , таких, что каждый элемент [math] a[l \ldots q][/math] меньше или равен [math] a[q][/math] , который в свою очередь, не превышает любой элемент подмассива [math] a[q+1 \ldots r][/math] . Индекс вычисляется в ходе процедуры разбиения.
- Подмассивы [math] a[l \ldots q][/math] и [math] a[q+1 \ldots r][/math] сортируются с помощью рекурсивного вызова процедуры быстрой сортировки.
- Поскольку подмассивы сортируются на месте, для их объединения не требуются никакие действия: весь массив [math] a[l \ldots r][/math] оказывается отсортированным.
Псевдокод
void quicksort(a: T[n], int l, int r) if l < r int q = partition(a, l, r) quicksort(a, l, q) quicksort(a, q + 1, r)
Для сортировки всего массива необходимо выполнить процедуру [math]\mathrm
Разбиение массива
Основной шаг алгоритма сортировки — процедура [math]\mathrm[/math] , которая переставляет элементы массива [math]a[l \ldots r][/math] типа [math] T [/math] нужным образом. Разбиение осуществляется с использованием следующей стратегии. Прежде всего, в качестве разделяющего элемента произвольно выбирается элемент [math] a[(l + r) / 2] [/math] . Далее начинается просмотр с левого конца массива, который продолжается до тех пор, пока не будет найден элемент, превосходящий по значению разделяющий элемент, затем выполняется просмотр, начиная с правого конца массива, который продолжается до тех пор, пока не отыскивается элемент, который по значению меньше разделяющего. Оба элемента, на которых просмотр был прерван, очевидно, находятся не на своих местах в разделенном массиве, и потому они меняются местами. Так продолжаем дальше, пока не убедимся в том, что слева от левого указателя не осталось ни одного элемента, который был бы больше по значению разделяющего, и ни одного элемента справа от правого указателя, которые были бы меньше по значению разделяющего элемента.
Переменная [math] v [/math] сохраняет значение разделяющего элемента [math] a[(l + r) / 2] [/math] , a [math] i [/math] и [math] j [/math] представляет собой, соответственно, указатели левого и правого просмотра. Цикл разделения увеличивает значение [math] i [/math] и уменьшает значение [math] j [/math] на [math] 1 [/math] , причем условие, что ни один элемент слева от [math] i [/math] не больше [math] v [/math] и ни один элемент справа от [math] j [/math] не меньше [math] v [/math] , не нарушается. Как только значения указателей пересекаются, процедура разбиения завершается.
int partition(a: T[n], int l, int r) T v = a[(l + r) / 2] int i = l int j = r while (i j) while (a[i] < v) i++ while (a[j] > v) j-- if (i j) break swap(a[i++], a[j--]) return j
Асимптотика
Худшее время работы
Предположим, что мы разбиваем массив так, что одна часть содержит [math]n - 1[/math] элементов, а вторая — [math]1[/math] . Поскольку процедура разбиения занимает время [math]\Theta(n)[/math] , для времени работы [math]T(n)[/math] получаем соотношение:
[math]T(n) = T(n - 1) + \Theta(n) = \sum\limits_^ \Theta(k) = \Theta(\sum\limits_^ k) = \Theta(n^2)[/math] .
Мы видим, что при максимально несбалансированном разбиении время работы составляет [math]\Theta(n^2)[/math] . В частности, это происходит, если массив изначально отсортирован.
Способ построить массив с максимальным количеством сравнений при выборе среднего элемента в качестве опорного
В некоторых алгоритмах быстрой сортировки в качестве опорного выбирается элемент, который стоит в середине рассматриваемого массива. Рассмотрим массив, на котором быстрая сортировка с выбором среднего элемента в качестве опорного сделает [math]\Theta(n^2)[/math] сравнений. Очевидно, что это будет достигаться при худшем случае (когда при каждом разбиении в одном массиве будет оказываться [math]1[/math] , а в другом [math] n - 1 [/math] элемент).
Заполним сначала массив [math]a[/math] длины [math]n[/math] элементами от [math]1[/math] до [math] n [/math] , затем применим следующий алгоритм (нумерация с нуля):
void antiQsort(a: T[n]) for i = 0 to n - 1 swap(a[i], a[i / 2])
Тогда на каждом шаге в качестве среднего элемента будет ставиться самый крупный элемент.
При выполнении [math]\mathrm[/math] делается [math]\Theta(n)[/math] сравнений из-за того, что с помощью индексов [math]i[/math] и [math]j[/math] мы проходим в лучшем случае [math]\Omega(n)[/math] элементов (если функция прекращает свою работу, как только индексы встречаются), в худшем случае [math]O(2n)[/math] элементов (если оба индекса полностью проходят массив). При каждом изменении индекса делается сравнение, значит, процедура [math]\mathrm[/math] делает [math]\Theta(n)[/math] сравнений с точностью до константы.
Рассмотрим, какой элемент будет выбираться опорным на каждом шаге. [math]\mathrm[/math] на каждом шаге меняет местами последний и центральный элементы, поэтому в центре оказывается самый крупный элемент. А [math]\mathrm[/math] делает абсолютно симметричные этой процедуре операции, но в другую сторону: меняет местами центральный элемент с последним, так что самый крупный элемент становится последним, а затем выполняет на массиве длины на один меньшей ту же операцию. Получается, что опорным всегда будет выбираться самый крупный элемент, так как [math] \mathrm [/math] на массиве любой длины будет выполнять операции, обратные [math]\mathrm[/math] . Фактически, [math]\mathrm[/math] — это [math]\mathrm[/math] , запущенная в другую сторону. Также стоит отметить, что процедура разбиения будет делать на каждом шаге только одну смену элементов местами. Сначала [math]i[/math] дойдет до середины массива, до опорного элемента, [math]j[/math] останется равным индексу последнего элемента. Затем произойдет [math]\mathrm[/math] и [math]i[/math] снова начнет увеличиваться, пока не дойдет до последнего элемента, [math]j[/math] опять не изменит свою позицию. Потом произойдет выход из [math]\mathrm[/math] .
Разбиение массива будет произведено [math]\Theta(n)[/math] раз, потому что разбиение производится на массивы длины [math]1[/math] и [math] n - 1 [/math] из-за того, что на каждом шаге разбиения в качестве опорного будет выбираться самый крупный элемент (оценка на худшее время работы доказана выше). Следовательно, на массиве, который строится описанным выше способом, выполняется [math]\Theta(n)[/math] [math]\mathrm[/math] и [math]\Theta(n)[/math] сравнений для каждого выполнения [math]\mathrm[/math] . Тогда быстрая сортировка выполнит [math]\Theta(n^2)[/math] сравнений для массива, построенного таким способом.
Способ построить массив с максимальным количеством сравнений при детерминированном выборе опорного элемента
Рассмотрим алгоритм построения массива, на котором быстрая сортировка с детерминированным выбором опорного элемента будет делать максимальное (в данном случае — [math]\Theta(n^2)[/math] ) количество сравнений. Такое число сравнений достигается при разбиении на массивы длиной [math]1[/math] и [math]n-1[/math] на каждой итерации. Создадим массив [math]a[/math] длины [math]n[/math] , заполненный элементами типа [math]pair[/math] . Такой элемент хранит пару значений [math](val, key)[/math] , где [math]val[/math] — элемент массива, а [math]key[/math] — индекс. Изначально [math]a[i][/math] элемент имеет вид [math](0, i)[/math] .
Далее, запустим для данного массива алгоритм быстрой сортировки. Сравниваем два элемента типа [math]pair[/math] по их значениям [math]val[/math] . На каждом шаге будем выполнять следующие действия: при обращении к [math]i[/math] -ому элементу в качестве опорного на шаге под номером [math]k[/math] , присвоим [math]val = n-k+1[/math] для элемента [math]a[i][/math] . Затем выполним шаг сортировки. После завершения работы алгоритма быстрой сортировки, дополнительно отсортируем получившиеся элементы [math]pair[/math] по значениям [math]key[/math] . Искомым будет являться массив элементов [math]val[/math] в соответствующей последовательности.
Пример для [math]n = 4[/math] , при последовательном выборе опорных элементов [math]2, 2, 1, 1[/math] .
Покажем, почему на данном массиве будет достигаться максимальное время работы быстрой сортировки. На этапе построения мы каждый раз присваивали опорному элементу максимальное значение. Следовательно, при выполнении [math]\mathrm[/math] алгоритм в качестве опорного всегда будет выбирать наибольший элемент массива (выборка будет производится в том же порядке ввиду детерминированности определения опорного элемента). Таким образом, так как каждый раз массив разбивается на две части — большие или равные опорному элементы и меньшие его — на каждом шаге имеем разбиение на массивы длины [math]1[/math] и [math]n-1[/math] , чего мы, собственно, и добивались. При таком выполнении алгоритма происходит [math]\Theta(n^2)[/math] разделений на два подмассива, и на каждом разделении выполняется [math]\Theta(n^2)[/math] сравнений. Следовательно, на данном массиве быстрая сортировка работает за [math]\Theta(n^2)[/math] .
Среднее время работы
Время работы алгоритма быстрой сортировки равно [math]O(n \log n)[/math] .
Пусть [math]X[/math] — полное количество сравнений элементов с опорным за время работы сортировки. Нам необходимо вычислить полное количество сравнений. Переименуем элементы массива как [math]z_1 \ldots z_n[/math] , где [math]z_i[/math] наименьший по порядку элемент. Также введем множество [math]Z_ = \ \ldots z_j\>[/math] .
Заметим, что сравнение каждой пары элементов происходит не больше одного раза, так как элемент сравнивается с опорным, а опорный элемент после разбиения больше не будет участвовать в сравнении.
Поскольку каждая пара элементов сравнивается не более одного раза, полное количество сравнений выражается как
[math]X = \sum\limits_^\sum\limits_^ X_[/math] , где [math]X_ = 1[/math] если произошло сравнение [math]z_i[/math] и [math]z_j[/math] и [math]X_ = 0[/math] , если сравнения не произошло.
Применим к обеим частям равенства операцию вычисления матожидания и воспользовавшись ее линейностью получим
Осталось вычислить величину [math]Pr\
Mатожидание времени работы быстрой сортировки будет [math]O(n \log n)[/math] .
Модификации
Нерекурсивная реализация быстрой сортировки
Для выполнения быстрой сортировки можно воспользоваться стеком, в котором в виде сортируемых подмассивов содержится перечень действий, которые предстоит выполнить. Каждый раз когда возникает необходимость в обработке подмассива, он выталкивается из стека. После разделения массива получаются два подмассива, требующих дальнейшей обработки, которые и заталкиваются в стек. Представленная ниже нерекурсивная реализация использует стек, заменяя рекурсивные вызовы помещением в стек параметров функции, а вызовы процедур и выходы из них — циклом, который осуществляет выборку параметров из стека и их обработку, пока стек не пуст. Мы помещаем больший из двух подмассивов в стек первым с тем, чтобы максимальная глубина стека при сортировке [math]N[/math] элементов не превосходила величины [math]\log n[/math] .
void quicksort(a: T[n], int l, int r) stack< pairint,int> > s s.push(l, r) while (s.isNotEmpty) (l, r) = s.pop() if (r l) continue int i = partition(a, l, r) if (i - l > r - i) s.push(l, i - 1) s.push(i + 1, r) else s.push(i + 1, r) s.push(l, i - 1)
В качестве альтернативного варианта можно использовать обычную рекурсивную версию, в которой вместо того, чтобы после разделения массива вызывать рекурсивно процедуру разделения для обоих найденных подмассивов, рекурсивный вызов делается только для меньшего подмассива, а больший обрабатывается в цикле в пределах этого же вызова процедуры. С точки зрения эффективности в среднем случае разницы практически нет: накладные расходы на дополнительный рекурсивный вызов и на организацию сравнения длин подмассивов и цикла — примерно одного порядка. Зато глубина рекурсии ни при каких обстоятельствах не превысит [math]\log n[/math] , а в худшем случае вырожденного разделения она вообще будет не более [math]1[/math] — вся обработка пройдёт в цикле первого уровня рекурсии.
Улучшенная быстрая сортировка
Выбор медианы из первого, среднего и последнего элементов в качестве разделяющего элемента и отсечение рекурсии меньших подмассивов может привести к существенному повышению эффективности быстрой сортировки. Функция [math]\mathrm[/math] возвращает индекс элемента, являющегося медианой трех элементов. После этого он и средний элемент массива меняются местами, при этом медиана становится разделяющим элементом. Массивы небольшого размера (длиной [math] M = 11[/math] и меньше) в процессе разделения игнорируются, затем для окончания сортировки используется сортировка вставками.
const int M = 10 void quicksort(a: T[n], int l, int r) if (r - l M) insertion(a, l, r) return int med = median(a[l], a[(l + r) / 2], a[r]) swap(a[med], a[(l + r) / 2]) int i = partition(a, l, r) quicksort(a, l, i) quicksort(a, i + 1, r)
Вообще, можно применять любые эвристики по выбору опорного элемента. Например, в стандартной реализации в Java в качестве разделяющего выбирается средний из 7 элементов, равномерно распределённых по массиву.
Быстрая сортировка с разделением на три части
Когда в сортируемом массиве имеется множество повторяющихся ключей предыдущие реализации быстрой сортировки можно существенно улучшить. Например массив, который состоит из равных ключей, вовсе не нуждается в дальнейшей сортировке, однако предыдущие реализации продолжают процесс разделения, подвергая обработке все более мелкие подмассивы, независимо от того, насколько большим является исходный файл.
В основу программы положено разделение массива на три части: на элементы,меньшие разделяющего элемента [math] a[l] \ldots a[i][/math] , элементы, равные разделяющему элементу [math]a[i+1] \ldots a[j-1][/math] , и элементы большие разделяющего элемента [math]a[j] \ldots a[r][/math] . После этого сортировка завершается двумя рекурсивными вызовами.
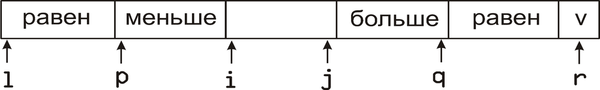
Разделение массива [math] a [/math]
Элементы массива равные разделяющему элементу находятся между [math] l [/math] и [math] p [/math] и между [math] q [/math] и [math] r [/math] . В разделяющем цикле, когда указатели просмотра перестают изменяться и выполняется обмен значениями [math] i [/math] и [math] j [/math] , каждый из этих элементов проверяется на предмет равенства разделяющему элементу. Если элемент, который сейчас находится слева, равен разделяющему элементу, то при помощи операции обмена он помещается в левую часть массива, если элемент, который сейчас находится справа, равен разделяющему элементу, то в результате операции обмена он помещается в правую часть массива. После того как указатели пересекутся, элементы, равные разделяющему элементу и находящиеся на разных концах массива, после операции обмена попадают в свои окончательные позиции. После этого указанные ключи могут быть исключены из подмассивов, для которых выполняются последующие рекурсивные вызовы.
void quicksort(a: T[n], int l, int r) T v = a[r] if (r l) return int i = l int j = r - 1 int p = l - 1 int q = r while (i j) while (a[i] < v) i++ while (a[j] > v) j-- if (i j) break swap(a[i], a[j]) if (a[i] == v) p++ swap(a[p], a[i]) i++ if (a[j] == v) q-- swap(a[q], a[j]) j-- swap(a[i], a[r]) j = i - 1 i++ for (int k = l; k p; k++, j--) swap(a[k], a[j]) for (int k = r - 1; k q; k--, i++) swap(a[k], a[i]) quicksort(a, l, j) quicksort(a, i, r)
Параллельная сортировка
Еще одной оптимизацией является параллельная сортировка на основе быстрой. Пусть, исходный набор данных расположен на первом процессоре, с него начинается работа алгоритма. Затем исходный массив окажется разделенным на две части, меньшая из которых передастся другому свободному процессору, большая останется на исходном для дальнейшей обработки. Далее обе части опять будут разделены и опять на двух исходных останутся большие части, а меньшие отправятся другим процессорам. В этом заключается ускорение алгоритма. При задействовании всех процессоров, все части параллельно будут сортироваться последовательным алгоритмом.
Introsort
Для предотвращения ухудшения времени работы быстрой сортировки до [math]O(n^2)[/math] при неудачных входных данных, также можно использовать алгоритм сортировки Introsort. Он использует быструю сортировку и переключается на пирамидальную сортировку, когда глубина рекурсии превысит некоторый заранее установленный уровень (например, логарифм от числа сортируемых элементов). Так как после нескольких итераций быстрой сортировки с применением разных эвристик массив с большей вероятностью окажется «почти отсортированным», то пирамидальная сортировка может довольно быстро закончить дело. Также, пирамидальная сортировка хороша тем, что требует [math]O(1)[/math] дополнительной памяти, в отличие от, например, сортировки слиянием, где потребуется [math]O(n)[/math] дополнительной памяти.
См. также
- Сортировка Шелла
- Сортировка кучей
- Сортировка слиянием
- Timsort
- Smoothsort
- PSRS-сортировка
Источники информации
- Википедия — Быстрая сортировка
- Wikipedia — Quicksort
- Wikipedia — Introsort
- Т. Кормен, Ч. Лейзерсон, Р. Ривест: Алгоритмы: построение и анализ глава 7
- Р. Седжвик: Фундаментальные алгоритмы на С++ части 1 - 4
- Дискретная математика и алгоритмы
- Сортировка
- Сортировки на сравнениях