Анализ данных с помощью pandas. Часть 0: введение, jupyter (ipython)

pandas — это Python библиотека для анализа и обработки данных. Она действительно быстрая и позволяет вам легко исследовать данные.
Цель этого цикла статей — дать конкретные примеры использования pandas.
Быстрый тур в IPython Notebook
Будет полезным повторить это в интерактивном режиме, поэтому лучше установить ipython с помощью pip:
sudo pip3 install jupyter pandas matplotlib После чего можно запустить сеанс ipython просто написав:
jupyter notebook После этого в браузере откроется сервер jupyter. Создадим Python 3 notebook.
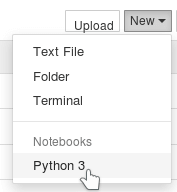
Во-первых, запустим код из ячейки.
Помимо этой кнопки, можно запускать код из ячейки с помощью Ctrl+Enter.
Одна из самых полезных вещей в IPython notebook это автодополнение.
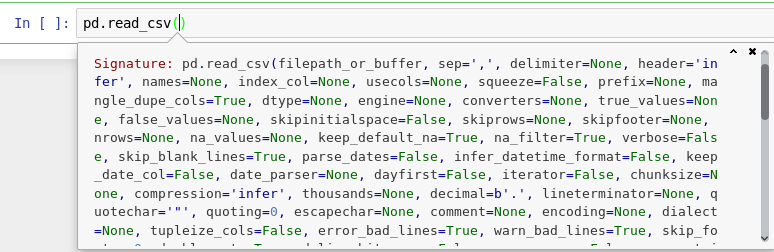
Попробуйте следующее: нажмите в ячейке сразу после read_csv( и нажмите Shift+Tab 4 раза, медленно. Посмотрите, что получится.
Вот что получается после 2 раз:
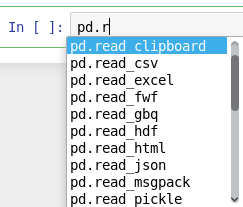
Хорошо, теперь попробуем автодополнение. Введите pd.r (первая буква функции) и посмотрите, какие варианты предлагаются.
Вы должны увидеть следующее:
Написание кода
Написание кода в ячейках абсолютно естественно.
Магические функции
IPython имеет множество магических функций. Далее идёт пример сравнения sum() с генератором списка и с помощью итератора, используя магическую функцию %time .
CPU times: user 20 ms, sys: 0 ns, total: 20 ms Wall time: 18.5 ms
4999950000
CPU times: user 8 ms, sys: 0 ns, total: 8 ms Wall time: 8.34 ms
4999950000
Для вставки кода на Python в комментарий заключайте его в теги
- Модуль csv - чтение и запись CSV файлов
- Создаём сайт на Django, используя хорошие практики. Часть 1: создаём проект
- Онлайн-обучение Python: сравнение популярных программ
- Книги о Python
- GUI (графический интерфейс пользователя)
- Курсы Python
- Модули
- Новости мира Python
- NumPy
- Обработка данных
- Основы программирования
- Примеры программ
- Типы данных в Python
- Видео
- Python для Web
- Работа для Python-программистов
- Сделай свой вклад в развитие сайта!
- Самоучитель Python
- Карта сайта
- Отзывы на книги по Python
- Реклама на сайте
Работаем с Pandas: основные понятия и реальные данные
Разбираемся в том, как работает библиотека Pandas, и проводим первый анализ данных.
Иллюстрация: Катя Павловская для Skillbox Media
Антон Яценко
Изучает Python, его библиотеки и занимается анализом данных. Любит путешествовать в горах.
Python используют для анализа данных и машинного обучения, подключая к нему различные библиотеки: Pandas, Matplotlib, NumPy, TensorFlow и другие. Каждая из них используется для решения конкретных задач.
Сегодня мы поговорим про Pandas: узнаем, для чего нужна эта библиотека, как импортировать её в Python, а также проанализируем свой первый датасет и выясним, в каких странах самый быстрый и самый медленный интернет.
Для чего нужна библиотека Pandas в Python
Pandas — главная библиотека в Python для работы с данными. Её активно используют аналитики данных и дата-сайентисты. Библиотека была создана в 2008 году компанией AQR Capital, а в 2009 году она стала проектом с открытым исходным кодом с поддержкой большого комьюнити.
Вот для каких задач используют библиотеку.
Аналитика данных: продуктовая, маркетинговая и другая. Работа с любыми данными требует анализа и подготовки: необходимо удалить или заполнить пропуски, отфильтровать, отсортировать или каким-то образом изменить данные. Pandas в Python позволяет быстро выполнить все эти действия, а в большинстве случаев ещё и автоматизировать их.
Data science и работа с большими данными. Pandas помогает подготовить и провести первичный анализ данных, чтобы потом использовать их в машинном или глубоком обучении.
Статистика. Библиотека поддерживает основные статистические методы, которые необходимы для работы с данными. Например, расчёт средних значений, их распределение по квантилям и другие.
Работа с Pandas
Для анализа данных и машинного обучения обычно используются особые инструменты: Google Colab или Jupyter Notebook. Это специализированные IDE, позволяющие работать с данными пошагово и итеративно, без необходимости создавать полноценное приложение.
В этой статье мы посмотрим на Google Colab, облачное решение для работы с данными, которое можно запустить в браузере на любом устройстве: десктопе, ноутбуке, планшете или даже смартфоне.
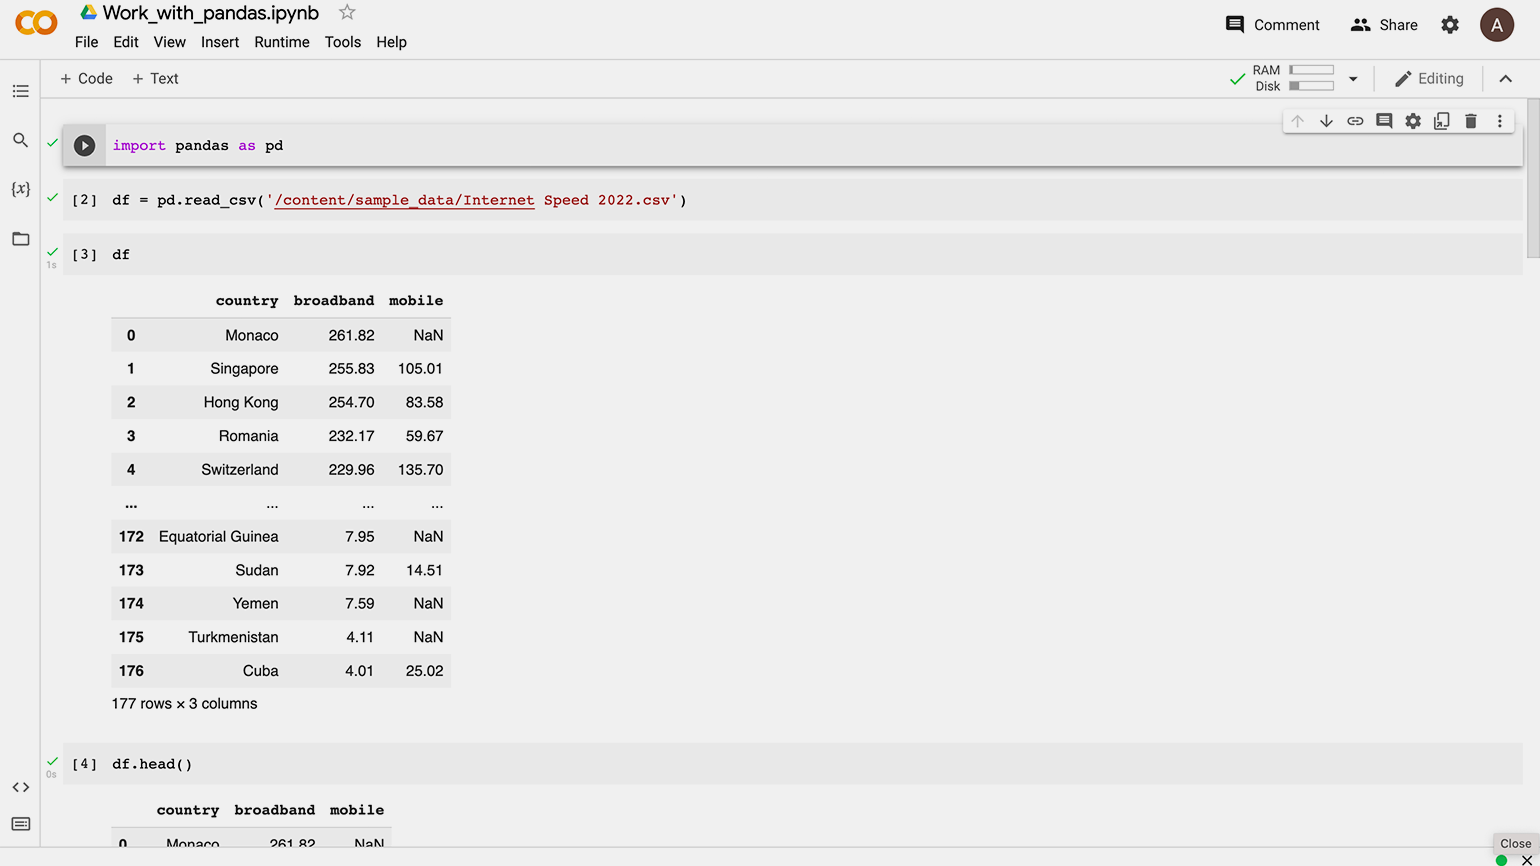
Каждая строчка кода на скриншоте — это одно действие, результат которого Google Colab и Jupyter Notebook сразу демонстрируют пользователю. Это удобно в задачах, связанных с аналитикой и data science.
Устанавливать Pandas при работе с Jupyter Notebook или Google Colab не требуется. Это стандартная библиотека, которая будет доступна сразу после их запуска. Останется только импортировать её в ваш код.
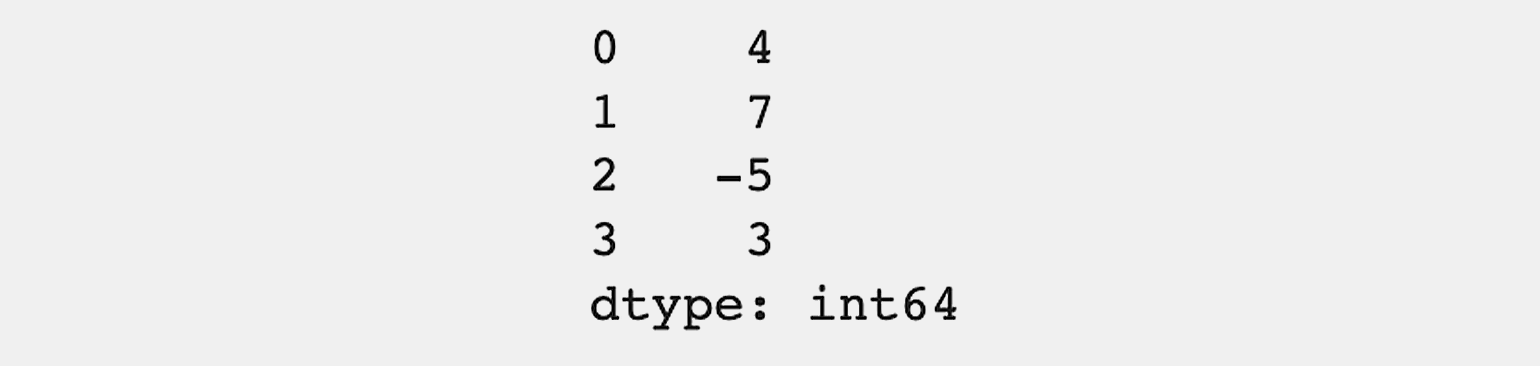
Series отображается в виде таблицы с индексами элементов в первом столбце и значениями во втором.
DataFrame — основной тип данных в Pandas, вокруг которого строится вся работа. Его можно представить в виде обычной таблицы с любым количеством столбцов и строк. Внутри ячеек такой «таблицы» могут быть данные самого разного типа: числовые, булевы, строковые и так далее.
У DataFrame есть и индексы строк, и индексы столбцов. Это позволяет удобно сортировать и фильтровать данные, а также быстро находить нужные ячейки.
Создадим простой DataFrame с помощью словаря и посмотрим на его отображение:
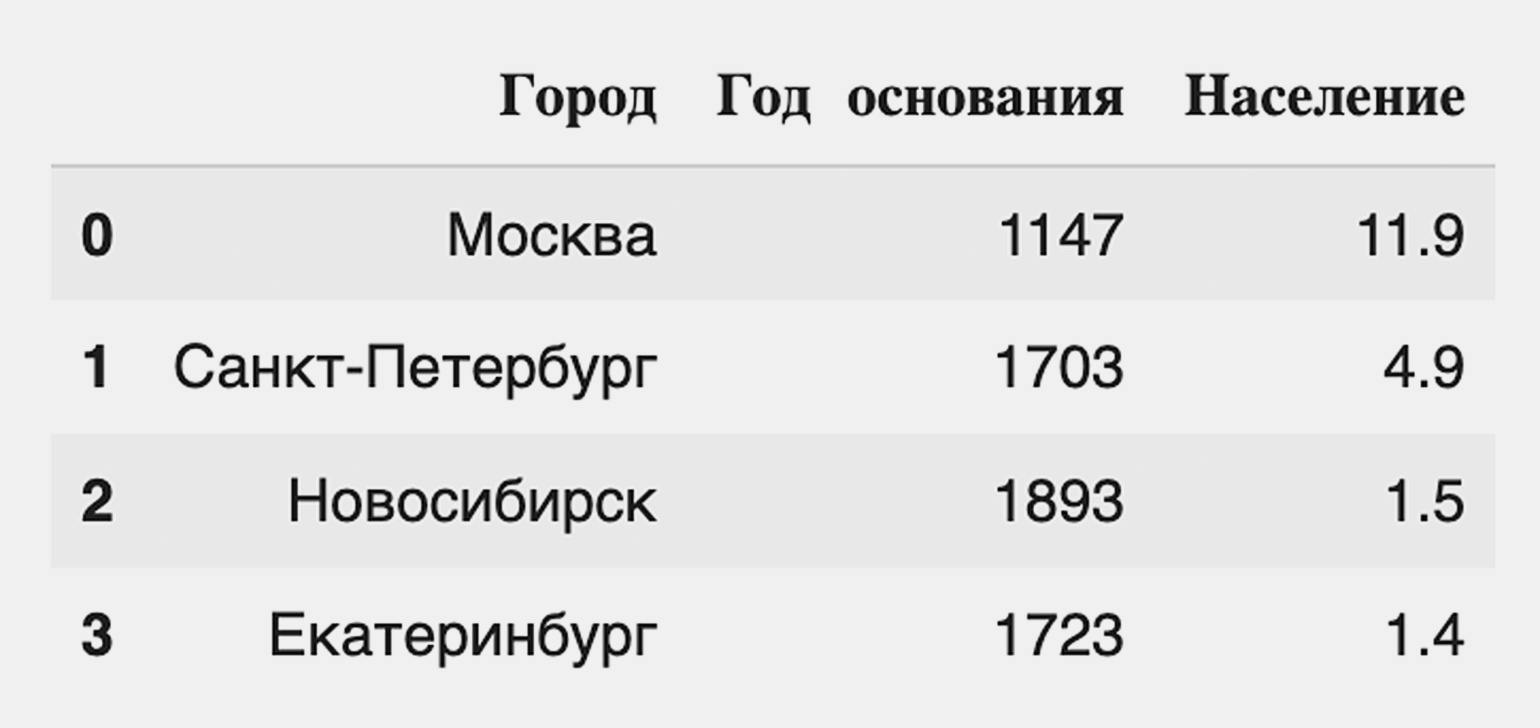
Мы видим таблицу, строки которой имеют индексы от 0 до 3, а «индексы» столбцов соответствуют их названиям. Легко заметить, что датафрейм состоит из трёх Series: Город, Год основания и Население. Оба типа индексов можно использовать для навигации по данным.
Импорт данных
Pandas позволяет импортировать данные разными способами. Например, прочесть их из словаря, списка или кортежа. Самый популярный способ — это работа с файлами .csv, которые часто применяются в анализе данных. Для импорта используют команду pd.read_csv().
read_csv имеет несколько параметров для управления импортом:
- sep позволяет явно указать разделитель, который используется в импортируемом файле. По умолчанию значение равно ,, что соответствует разделителю данных в файлах формата .csv. Этот параметр полезен при использовании нестандартных разделителей в исходном файле, например табуляции или точки с запятой;
- dtype позволяет указать тип данных в столбцах после загрузки файла формата .csv. Полезно в тех случаях, когда формат данных автоматически определился неверно. Например, даты часто импортируются в виде строковых переменных, хотя для них существует отдельный тип.
Подробно параметры, позволяющие настроить импорт csv, описаны в документации.
Давайте импортируем датасет с информацией о скорости мобильного и стационарного интернета в отдельных странах. Готовый датасет скачиваем с Kaggle. Это файл в формате .csv. Параметры для read_csv не указываем, так как наши данные уже подготовлены для анализа.
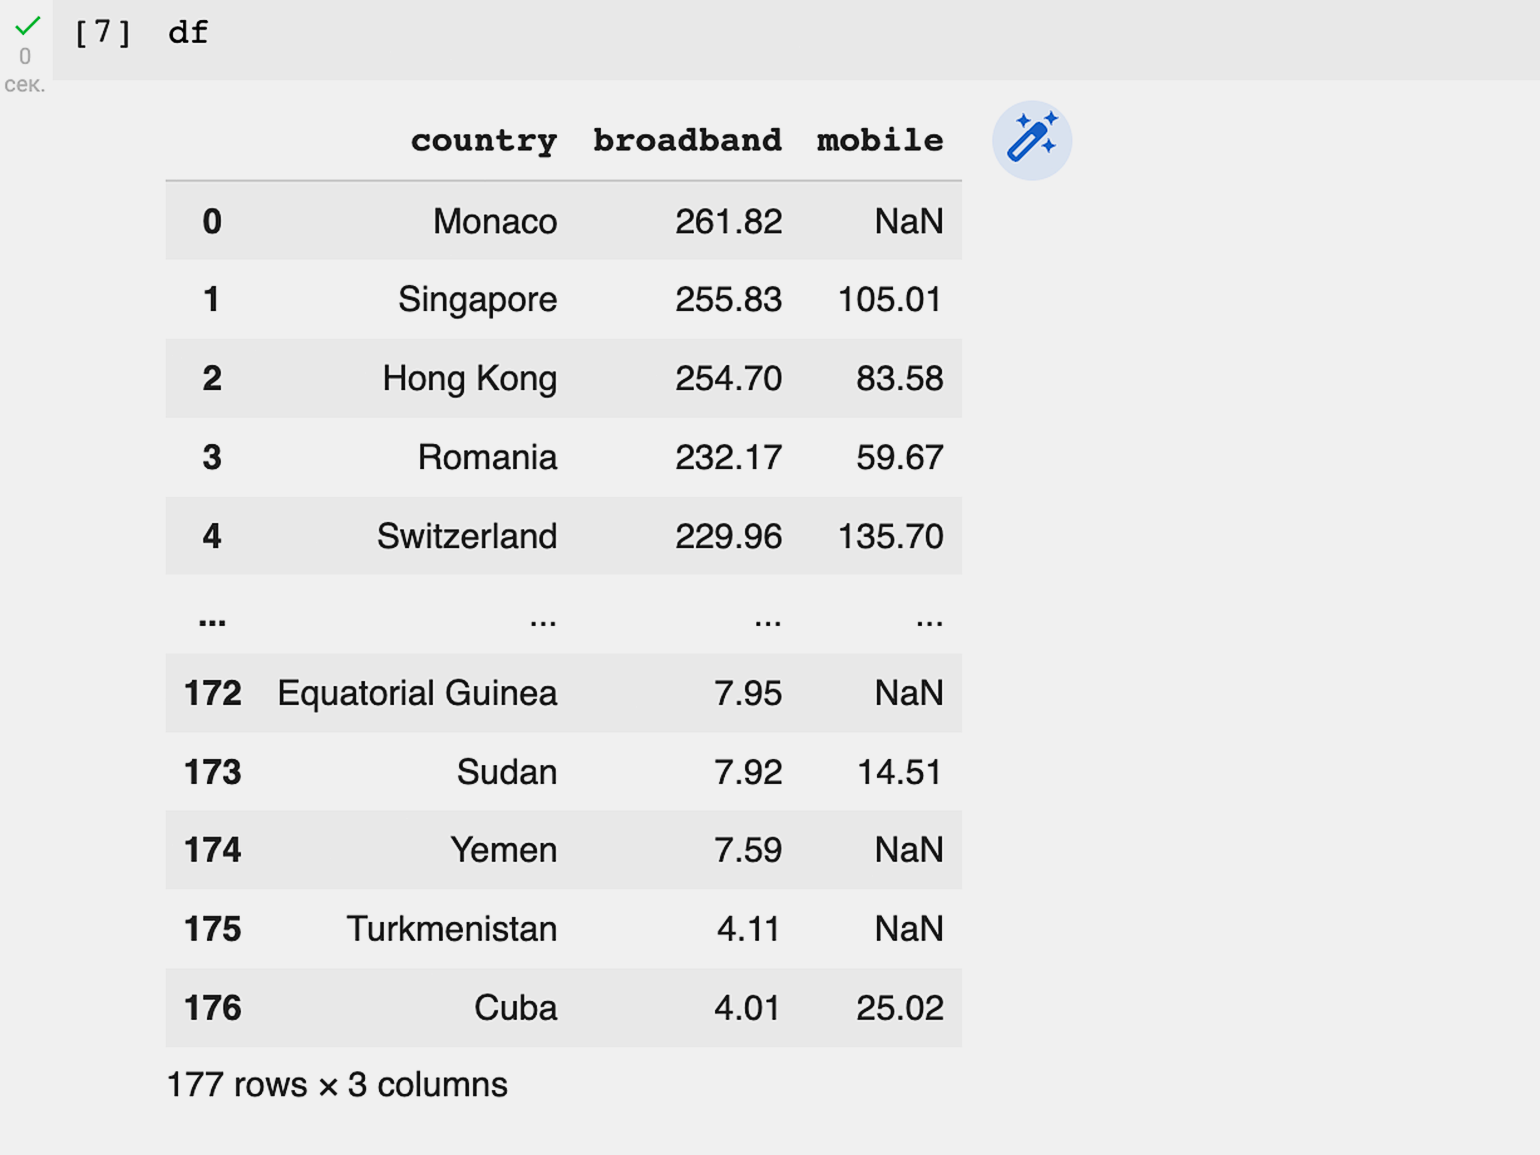
В верхней части датафрейма мы видим названия столбцов: country (страна), broadband (средняя скорость интернета) и mobile (средняя скорость мобильного интернета). Слева указаны индексы — от 0 до 176. То есть всего у нас 177 строк. В нижней части таблицы Pandas отображает и эту информацию.
Выводить таблицу полностью не обязательно. Для знакомства с данными достаточно показать пять первых или пять последних строк. Сделать это можно с помощью df.head() или df.tail() соответственно. В скобках можно указать число строк, которое которые будут выведены. По умолчанию параметр равен 5.
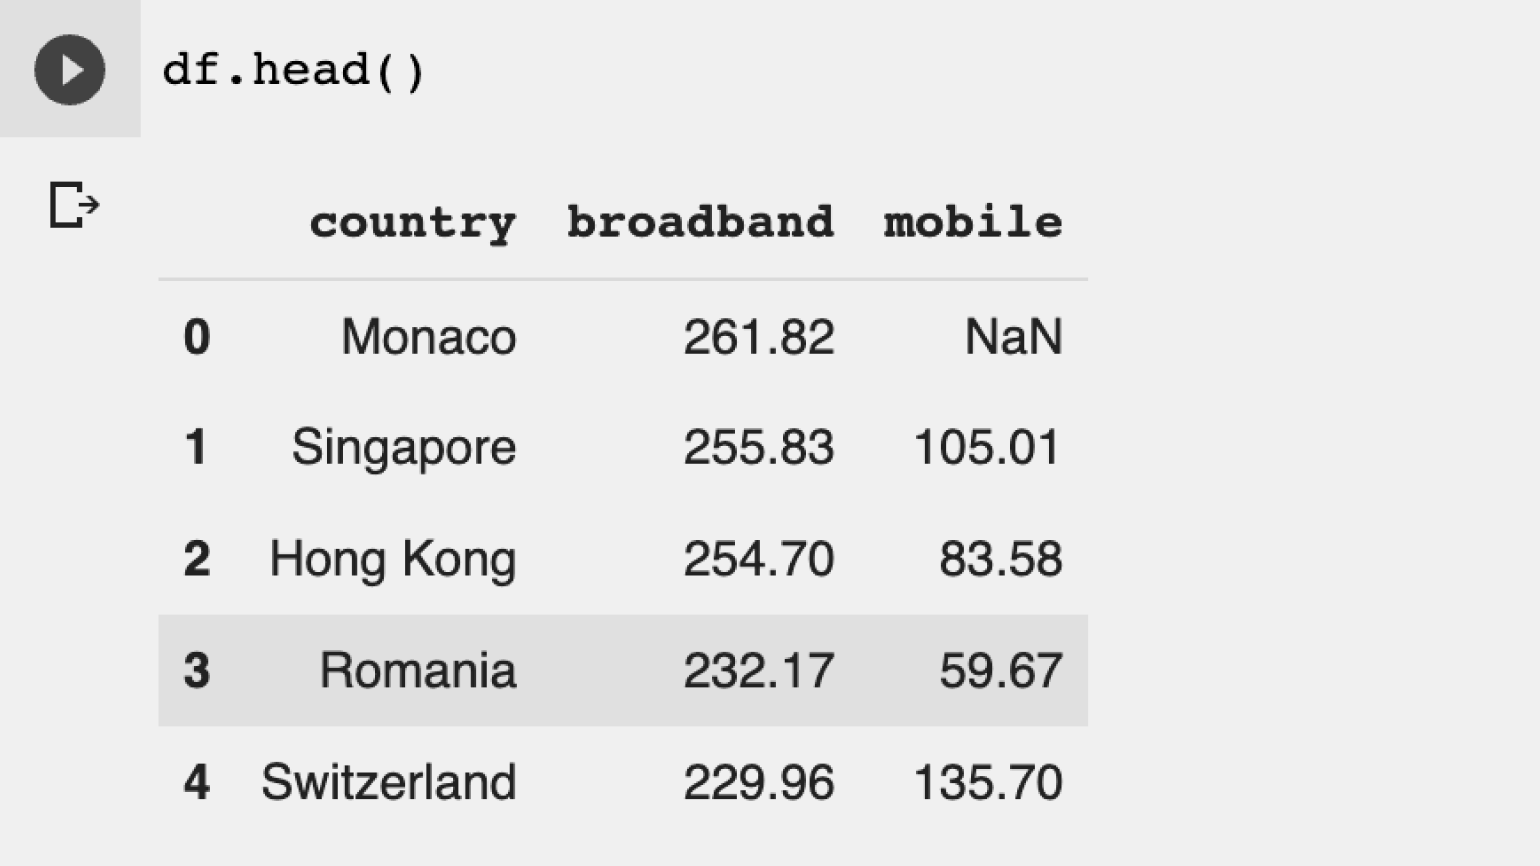
Так намного удобнее. Мы можем сразу увидеть названия столбцов и тип данных в столбцах. Также в некоторых ячейках мы видим значение NaN — к нему мы вернёмся позже.
Изучаем данные и описываем их
Теперь нам надо изучить импортированные данные. Действовать будем пошагово.
Шаг 1. Проверяем тип данных в таблице. Это поможет понять, в каком виде представлена информация в датасете — а иногда и найти аномалии. Например, даты могут быть сохранены в виде строк, что неудобно для последующего анализа. Проверить это можно с помощью стандартного метода:
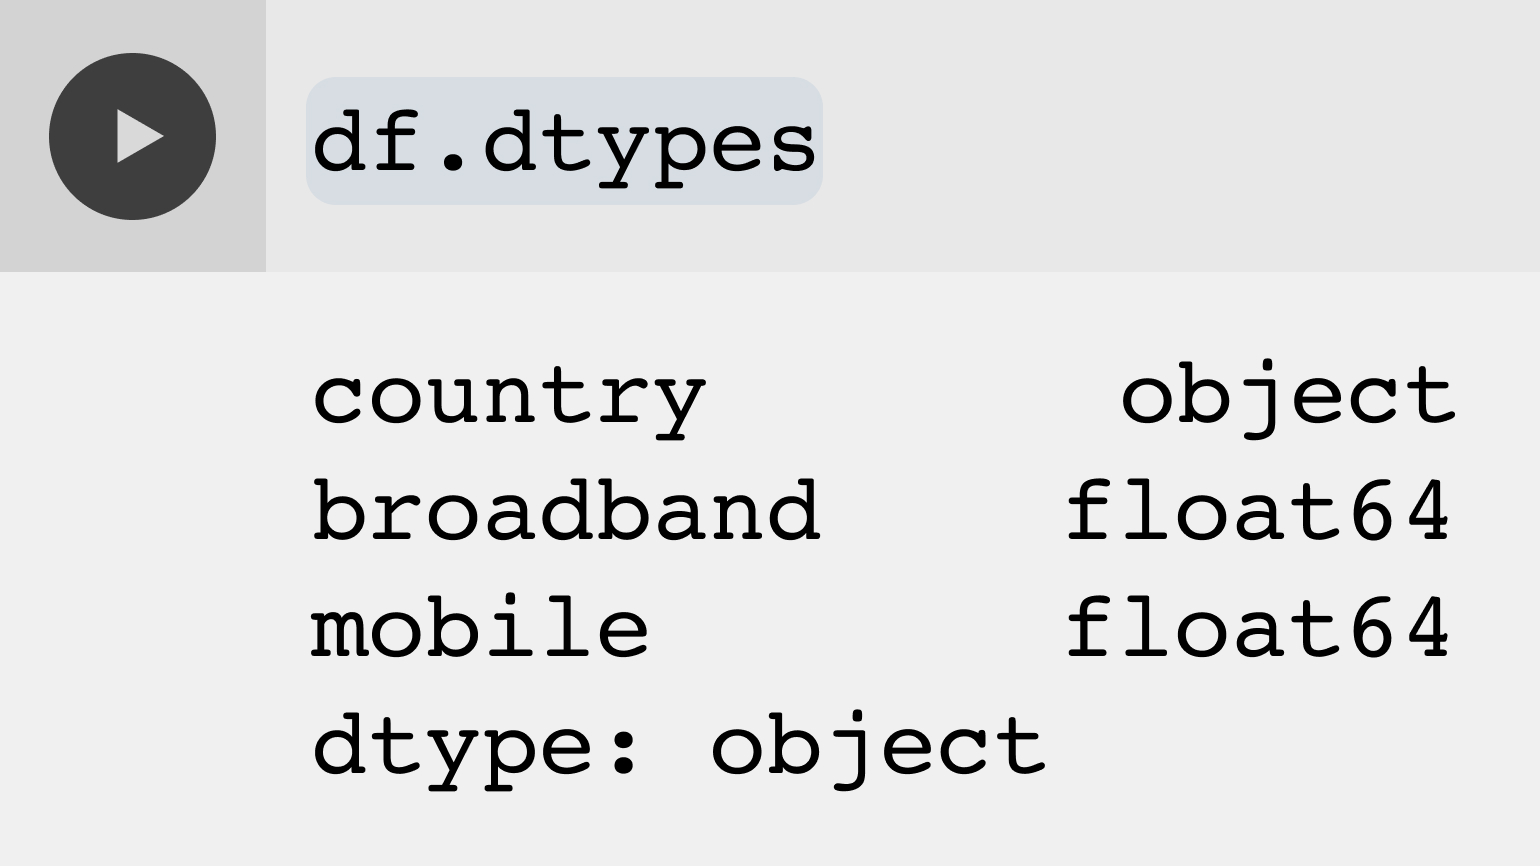
- столбец country представляет собой тип object. Это тип данных для строковых и смешанных значений;
- столбцы broadband и mobile имеют тип данных float, то есть относятся к числам с плавающей точкой.
Шаг 2. Быстро оцениваем данные и делаем предварительные выводы. Сделать это можно очень просто: для этого в Pandas существует специальный метод describe(). Он показывает среднее со стандартным отклонением, максимальные, минимальные значения переменных и их разделение по квантилям.
Посмотрим на этот метод в деле:
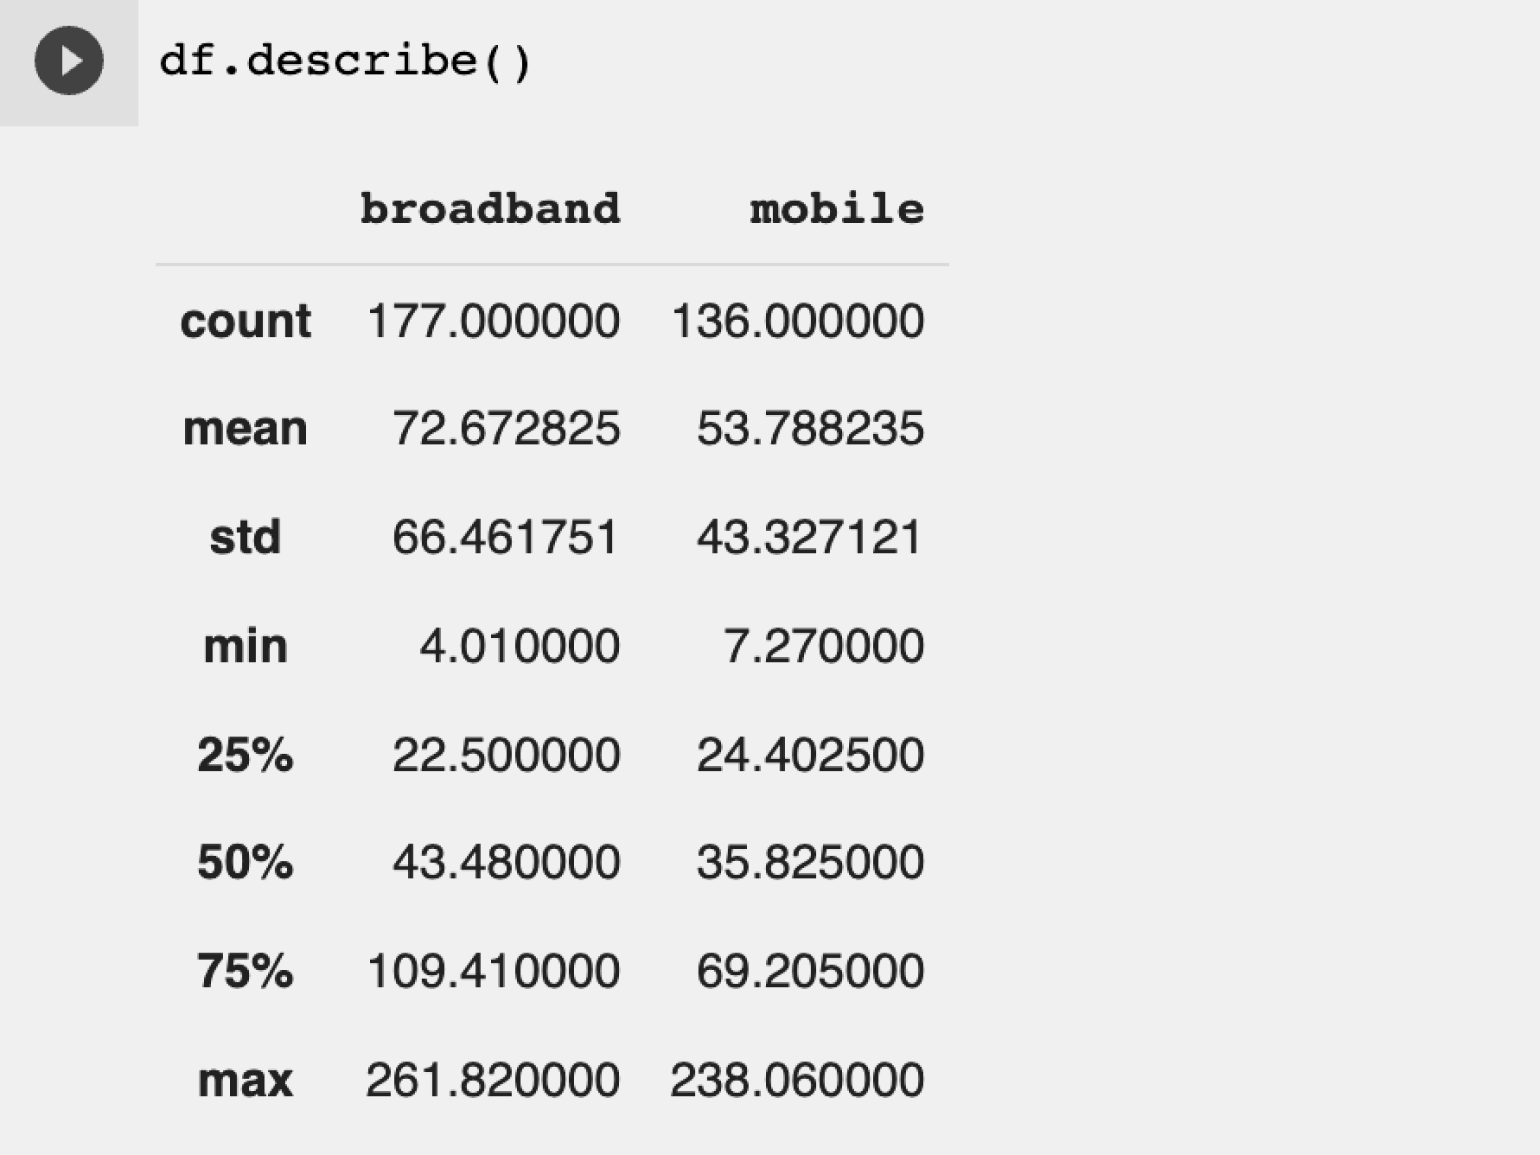
Пройдёмся по каждой строчке:
- count — это количество заполненных строк в каждом столбце. Мы видим, что в столбце с данными о скорости мобильного интернета есть пропуски.
- mean — среднее значение скорости обычного и мобильного интернета. Уже можно сделать вывод, что мобильный интернет в большинстве стран медленнее, чем кабельный.
- std — стандартное отклонение. Важный статистический показатель, показывающий разброс значений.
- min и max — минимальное и максимальное значения.
- 25%, 50% и 75% — значения скорости интернета по процентилям. Если не углубляться в статистику, то процентиль — это число, которое показывает распределение значений в выборке. Например, в выборке с мобильным интернетом 25-й процентиль показывает, что 25% от всех значений скорости интернета меньше, чем 24,4.
Обратите внимание, что этот метод работает только для чисел. Информация для столбца с названием стран отсутствует.
Какой вывод делаем? Проводной интернет в большинстве стран работает быстрее, чем мобильный. При этом скорость проводного интернета в 75% случаев не превышает 110 Мбит/с, а мобильного — 69 Мбит/сек.
Шаг 3. Сортируем и фильтруем записи. В нашем датафрейме данные уже отсортированы от большего к меньшему по скорости проводного интернета. Попробуем найти страну с наилучшим мобильным интернетом. Для этого используем стандартный метод sort_values, который принимает два параметра:
- Название столбца, по которому происходит сортировка, обязательно должно быть заключено в одинарные или двойные кавычки.
- Параметр ascending= указывает на тип сортировки. Если мы хотим отсортировать значения от большего к меньшему, то параметру присваиваем False. Для сортировки от меньшего к большему используем True.
Перейдём к коду:
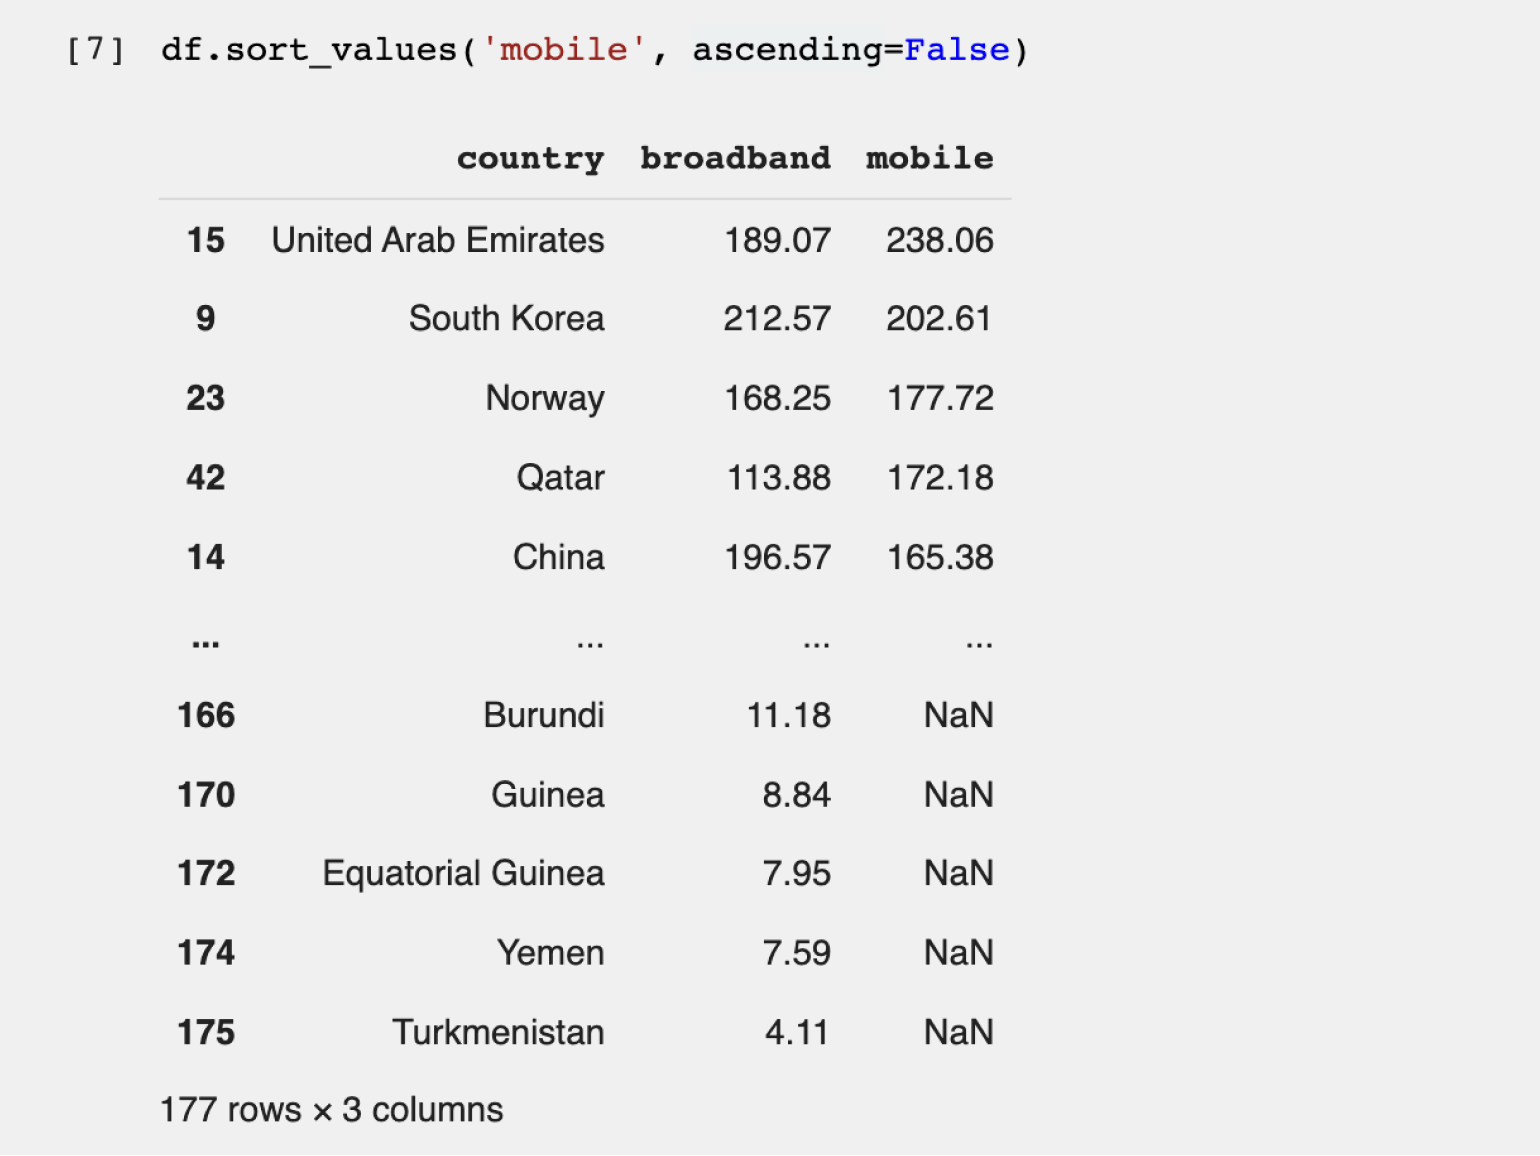
Теперь рейтинг стран другой — пятёрка лидеров поменялась (потому что мы отсортировали данные по другому значению). Мы выяснили, что самый быстрый мобильный интернет в ОАЭ.
Но есть нюанс. Если вернуться к первоначальной таблице, отсортированной по скорости проводного интернета, можно заметить, что у лидера — Монако — во втором столбце написано NaN.
NaN в Python указывает на отсутствие данных. Поэтому мы не знаем скорость мобильного интернета в Монако из этого датасета и не можем сделать однозначный вывод о лидерах в мире мобильной связи.
Попробуем отфильтровать значения, убрав из датафрейма страны с неизвестной скоростью мобильного интернета, и посмотрим на худшие по показателю страны (если оставить NaN, он будет засорять «дно» таблицы и увидеть реальные значения по самому медленному мобильному интернету будет сложновато).
В Pandas существуют различные способы фильтрации для удаления NaN. Мы воспользуемся методом dropna(), который удаляет все строки с пропусками. Важно, что удаляется полностью строка, содержащая NaN, а не только ячейки с пропущенными значениями в столбце с пропусками.
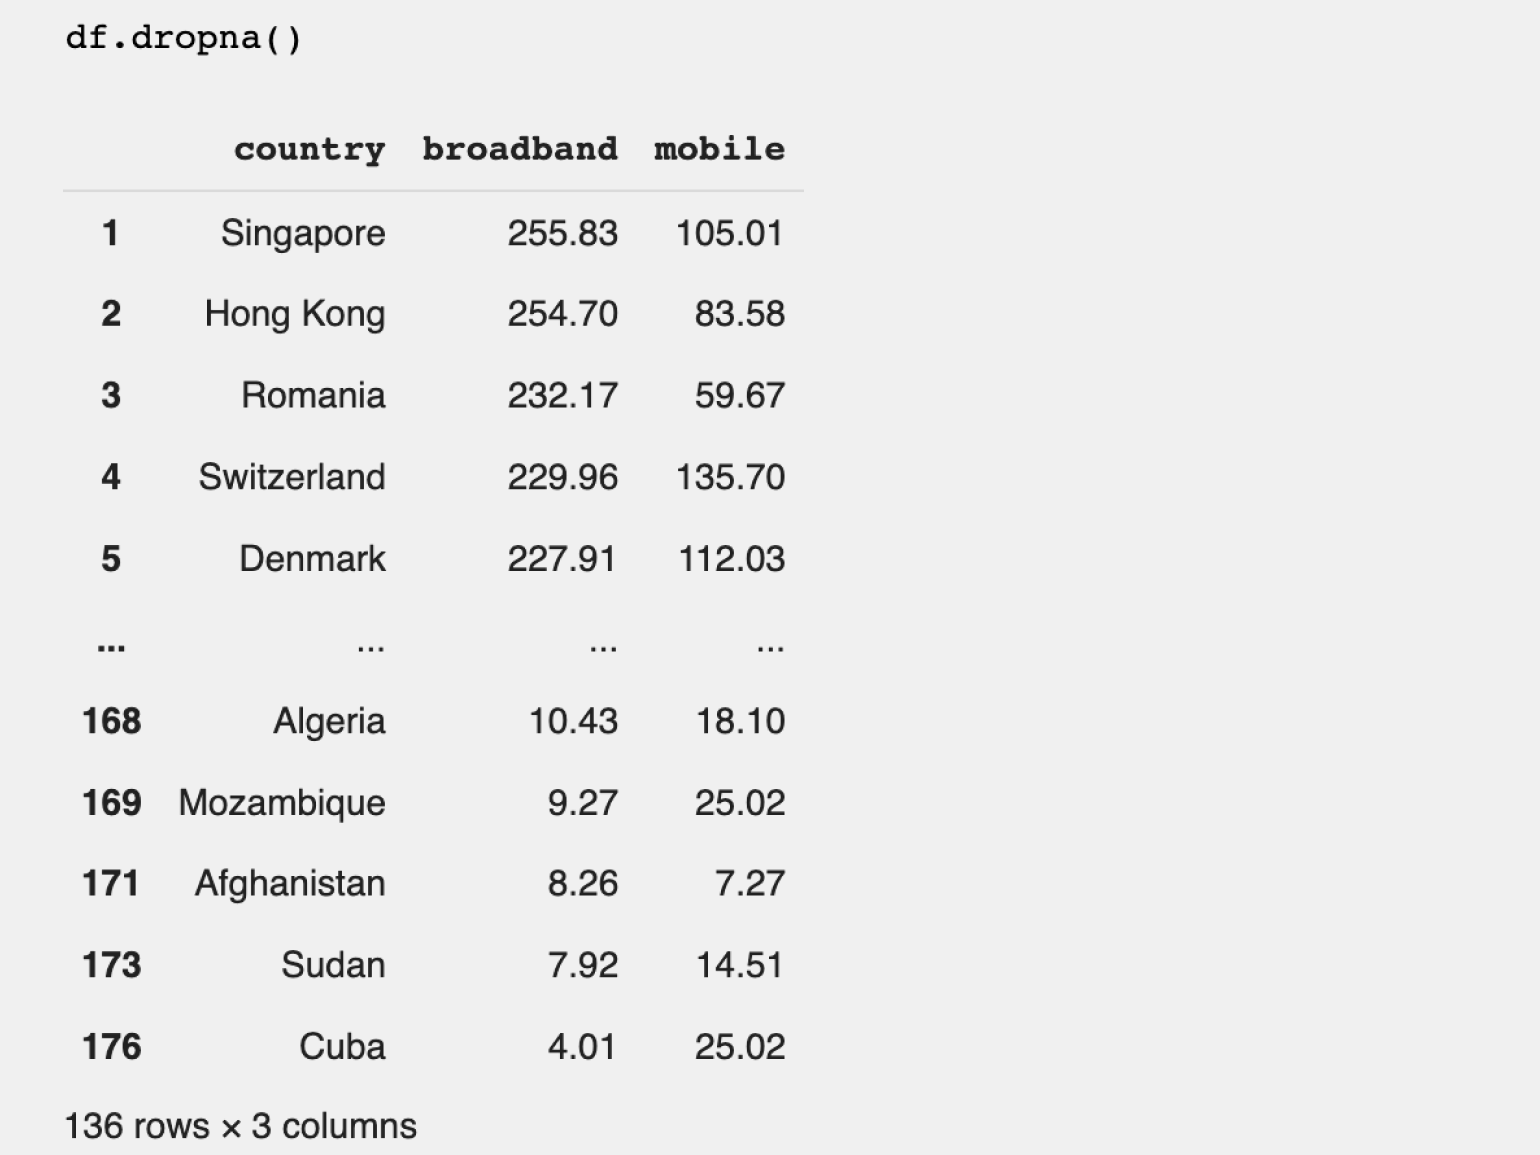
Количество строк в датафрейме при удалении пустых данных уменьшилось до 136. Если вернуться ко второму шагу, то можно увидеть, что это соответствует количеству заполненных строк в столбце mobile в начальном датафрейме.
Сохраним результат в новый датафрейм и назовём его df_without_nan. Изначальный DataFrame стараемся не менять, так как он ещё может нам понадобиться.
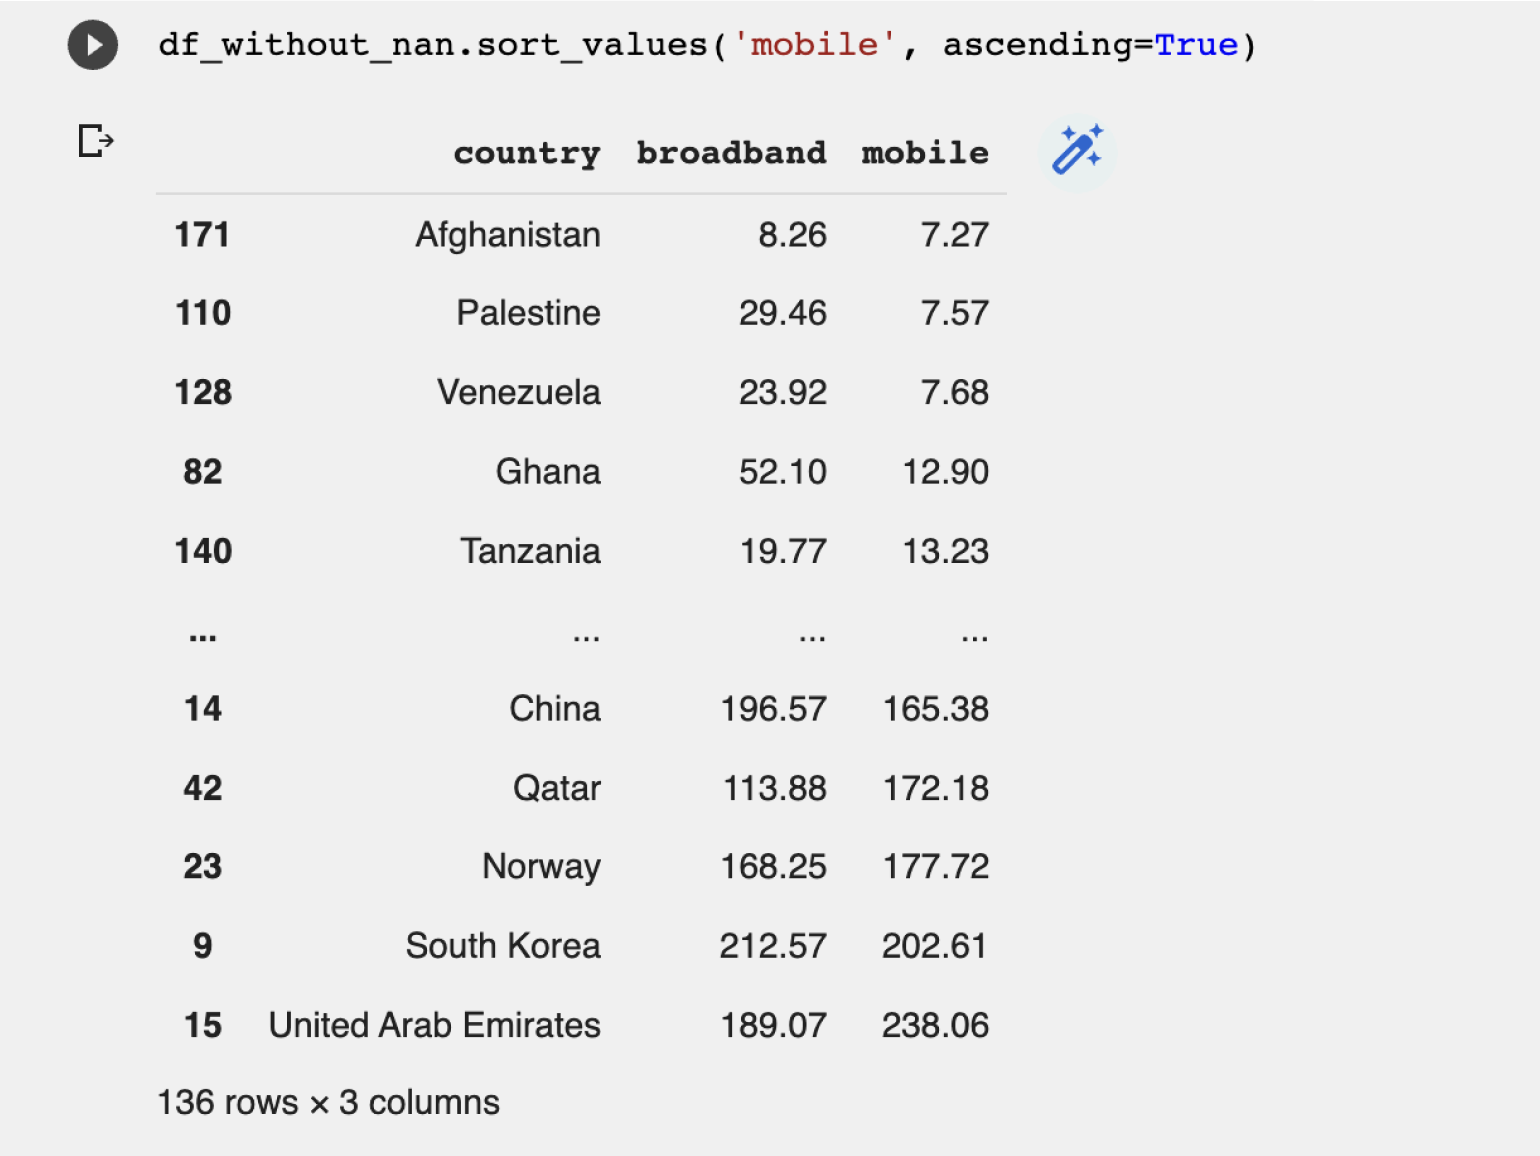
Худший мобильный интернет в Афганистане, далее с небольшим отставанием идут Палестина и Венесуэла.
Как можно редактировать датафрейм
Кроме как работать с существующим датафреймом, мы можем менять готовый датафрейм в зависимости от своих задач: добавлять новые строки, удалять существующие, агрегировать данные и так далее.
Вернём нашему df первоначальный вид. Загрузим csv с датасетом повторно:
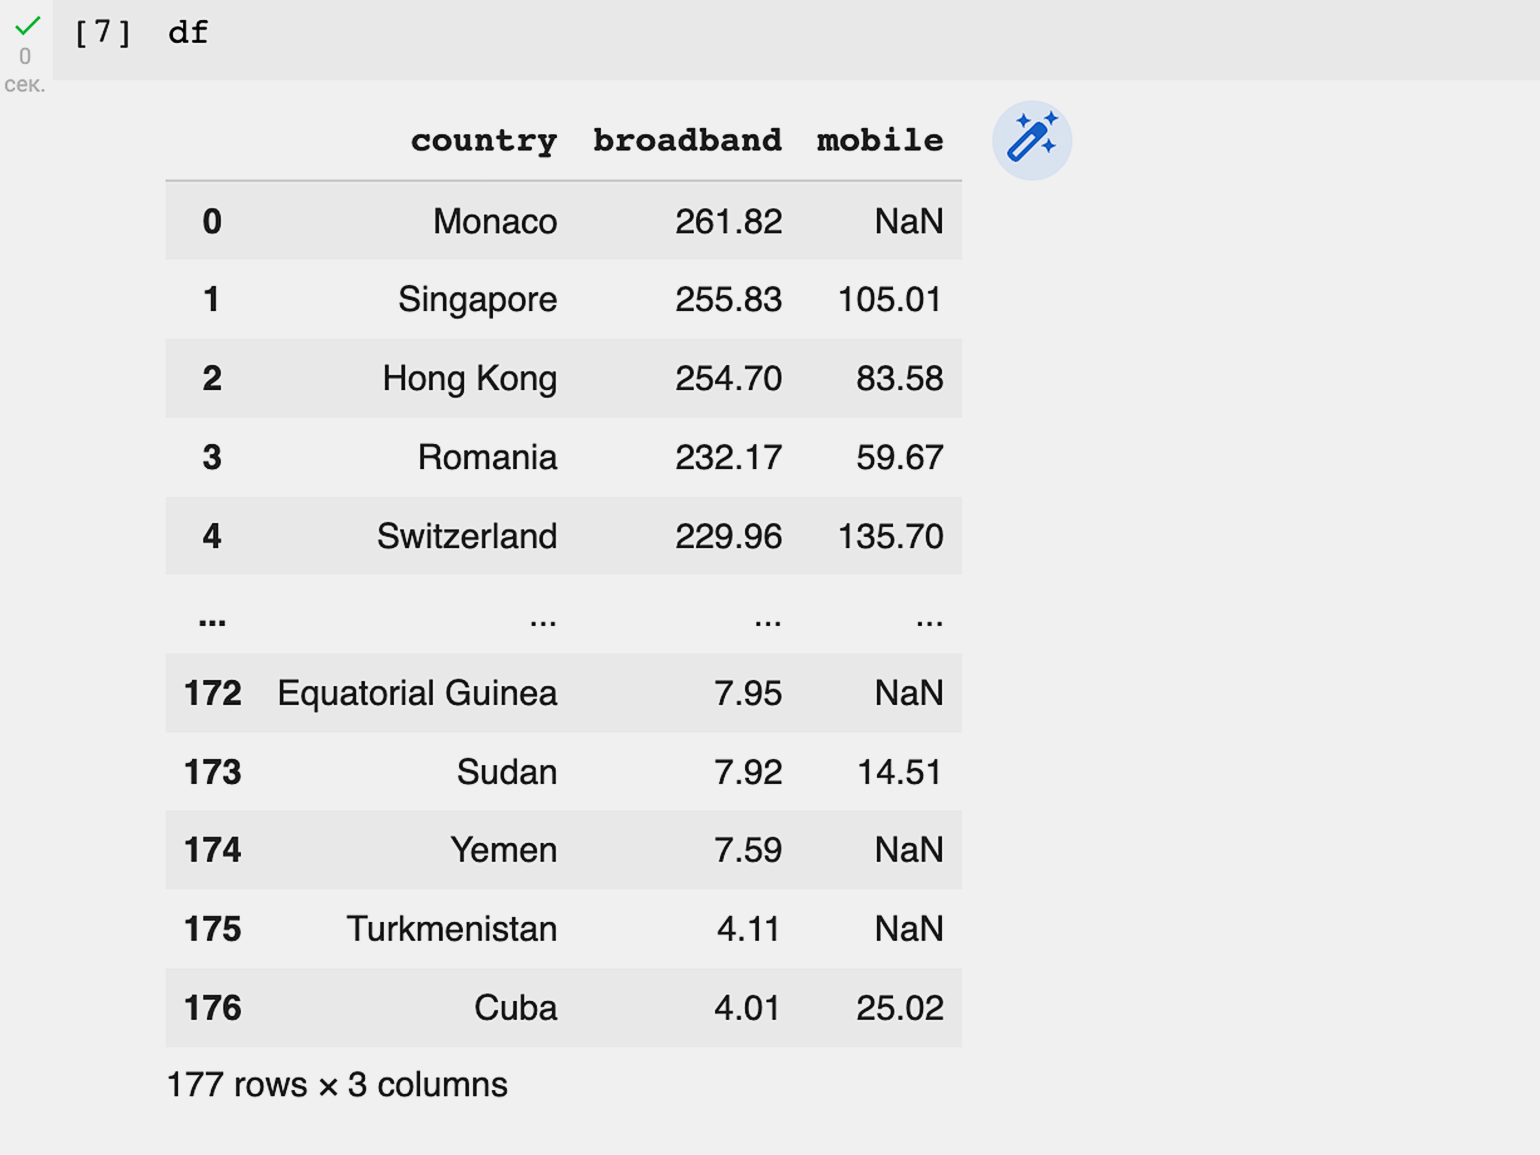
177 строк — все страны, в том числе те, данные о скорости интернета которых отсутствуют, в списке есть.
Добавление строки
Добавим в наш датафрейм новую страну. Так как в списке их уже 177, пусть это будет Галактическая Республика из «Звёздных войн».
Для добавления информации в датафрейм используется метод concat:
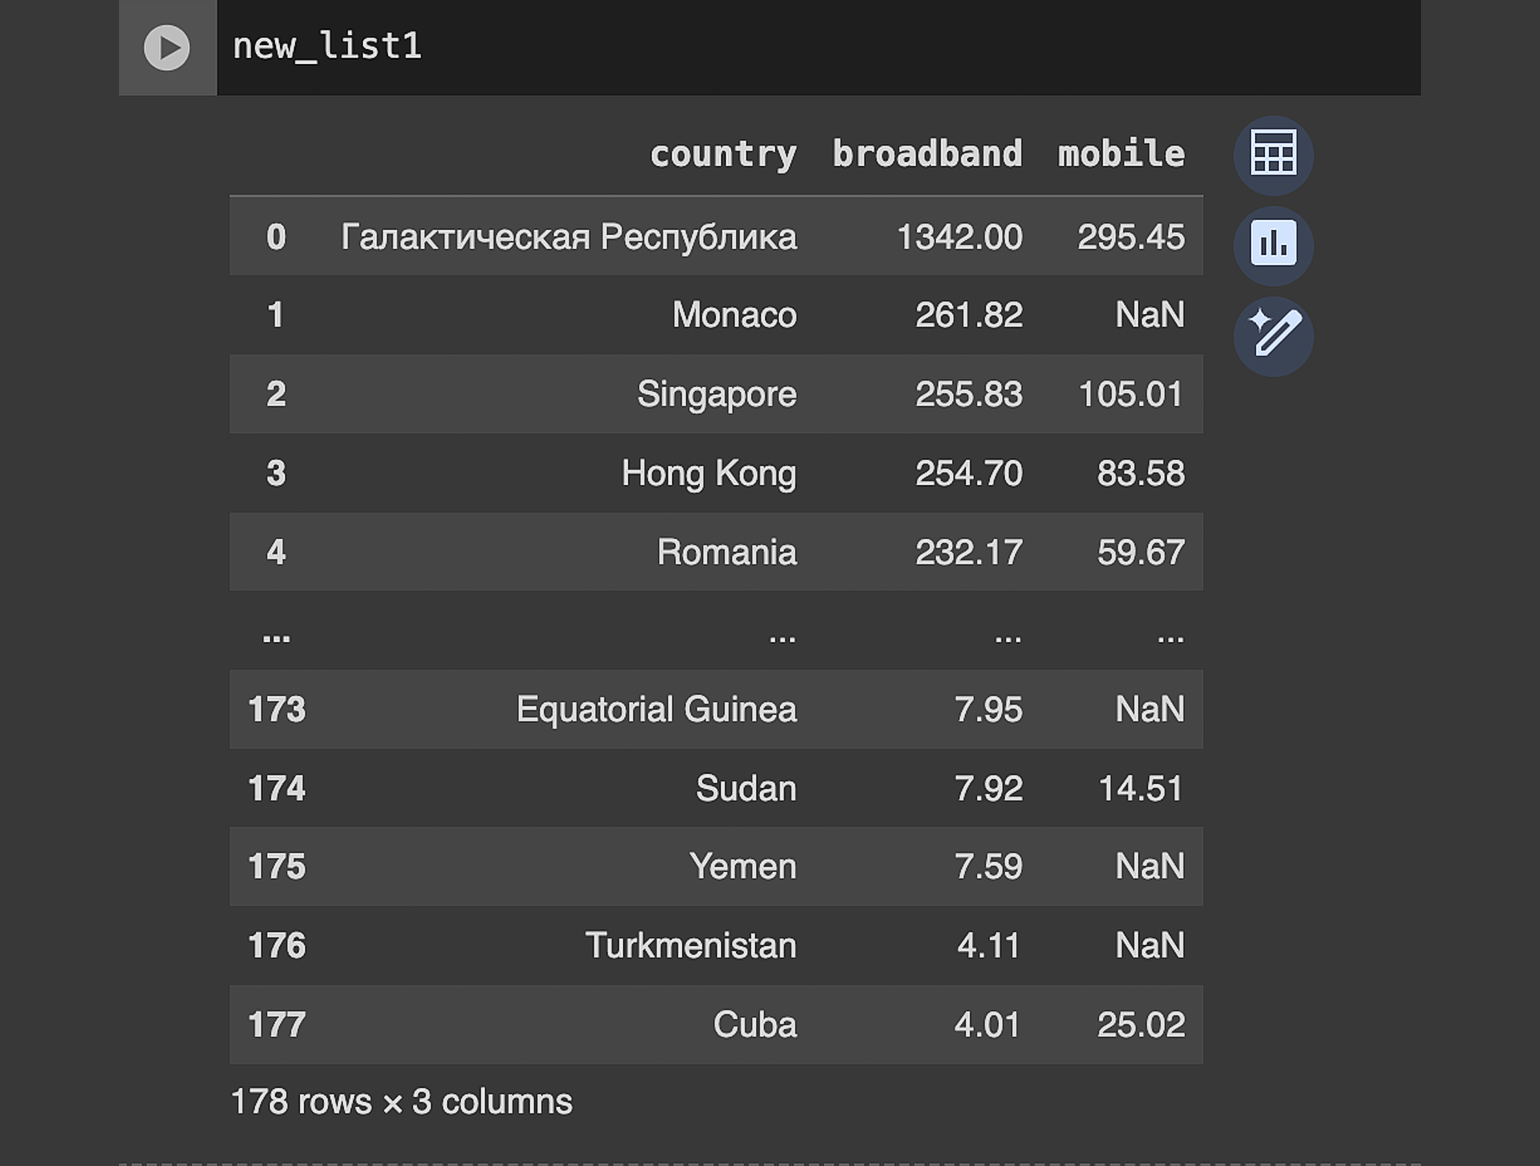
Всё получилось. Галактическая Республика в нашей таблице.
Удаление строк
Строки в Pandas удаляются методом drop. Давайте теперь с его помощью удалим несуществующую страну, которую мы добавили ранее в наш датафрейм:
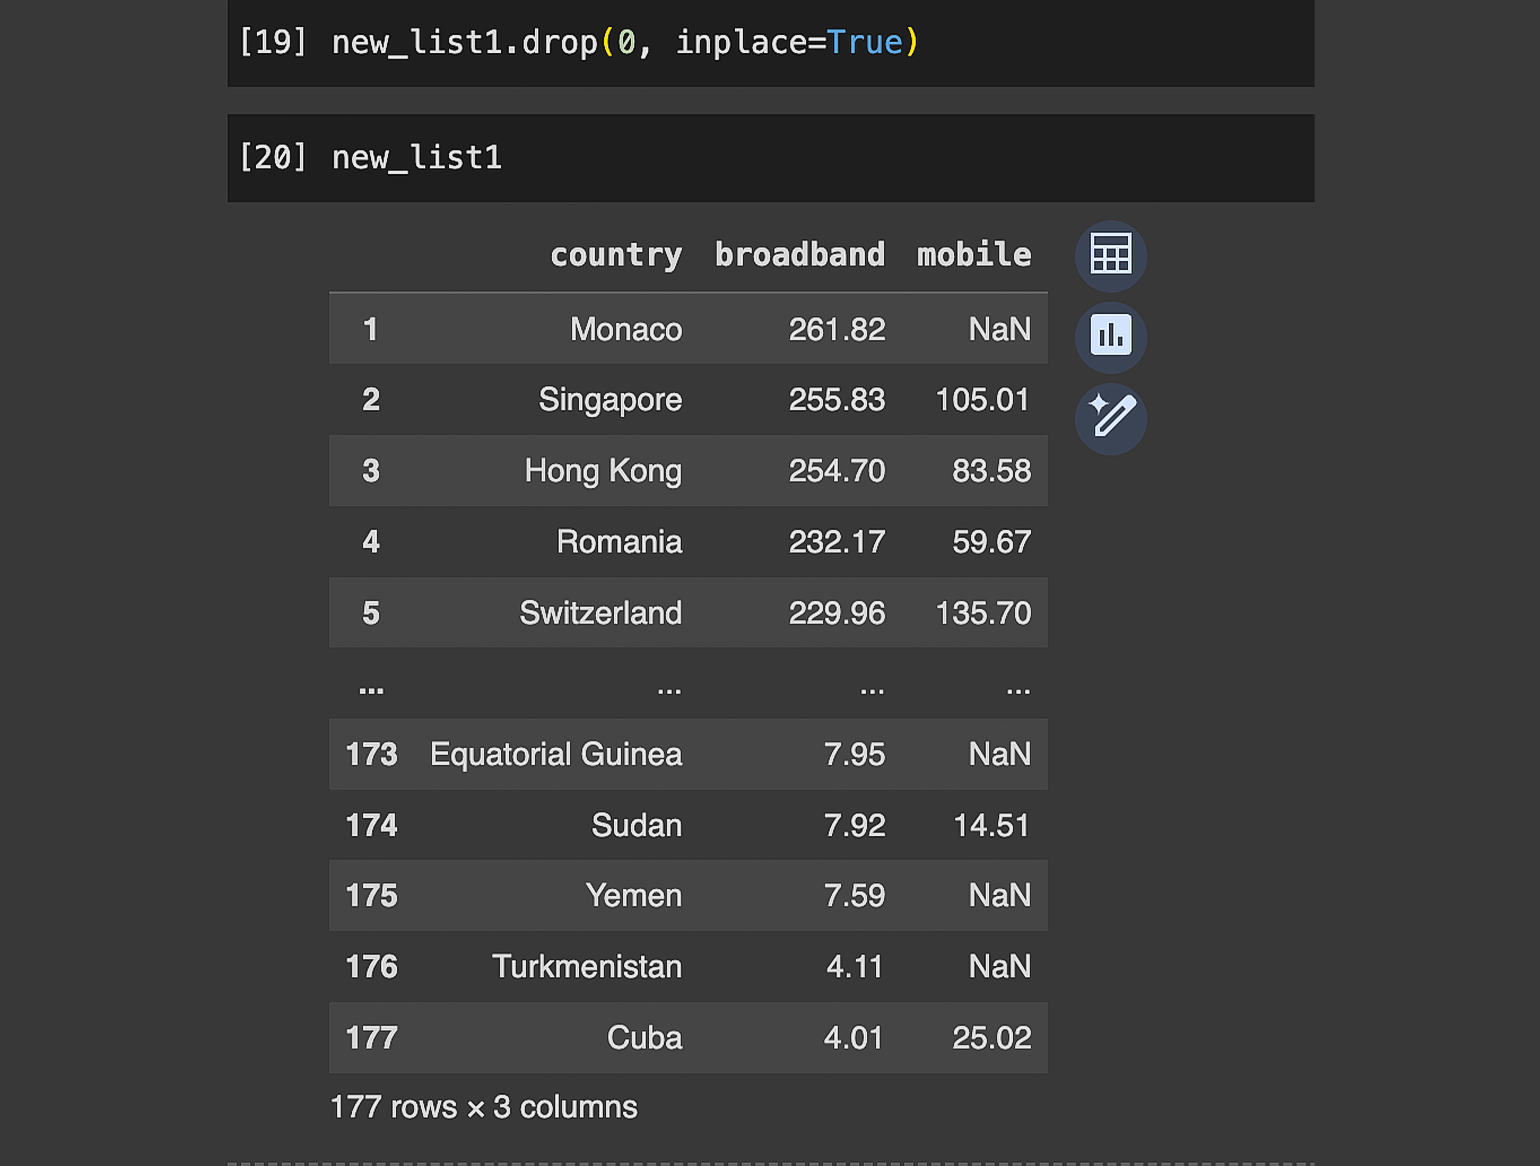
Галактической Республики больше нет. Датафрейм вернулся в изначальный вид.
Фильтрация строк
Иногда в датафрейме нужно найти определённую строку. Сделать это можно двумя способами: по индексному значению и индексу. Попробуем оба метода.
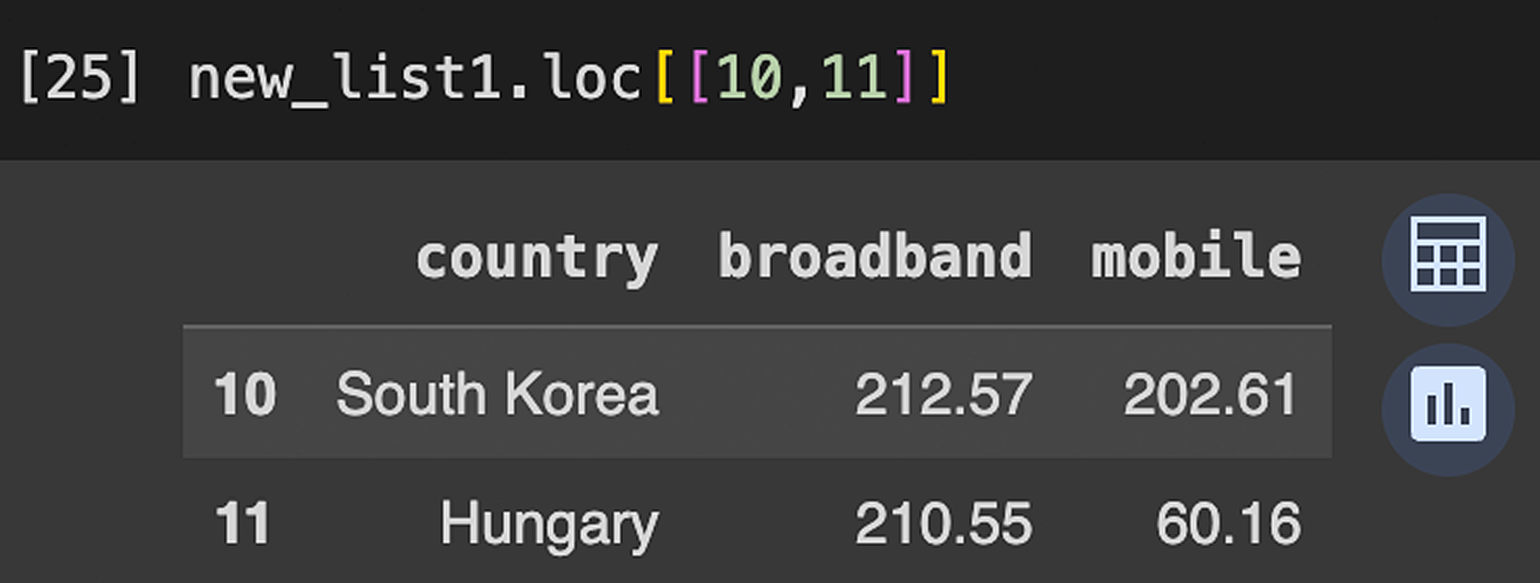
Фильтрация по индексному значению. Оно соответствует первому столбцу в датафрейме. В нашем случае индексные значения — это числа от 0 до 177.
Выведем на экран страны с индексными значениями 10 и 11:
Фильтрация по индексу. Он в датафрейме всегда начинается с 0. Сделаем срез стран с индексами 5–8. Для этого используется метод iloc.
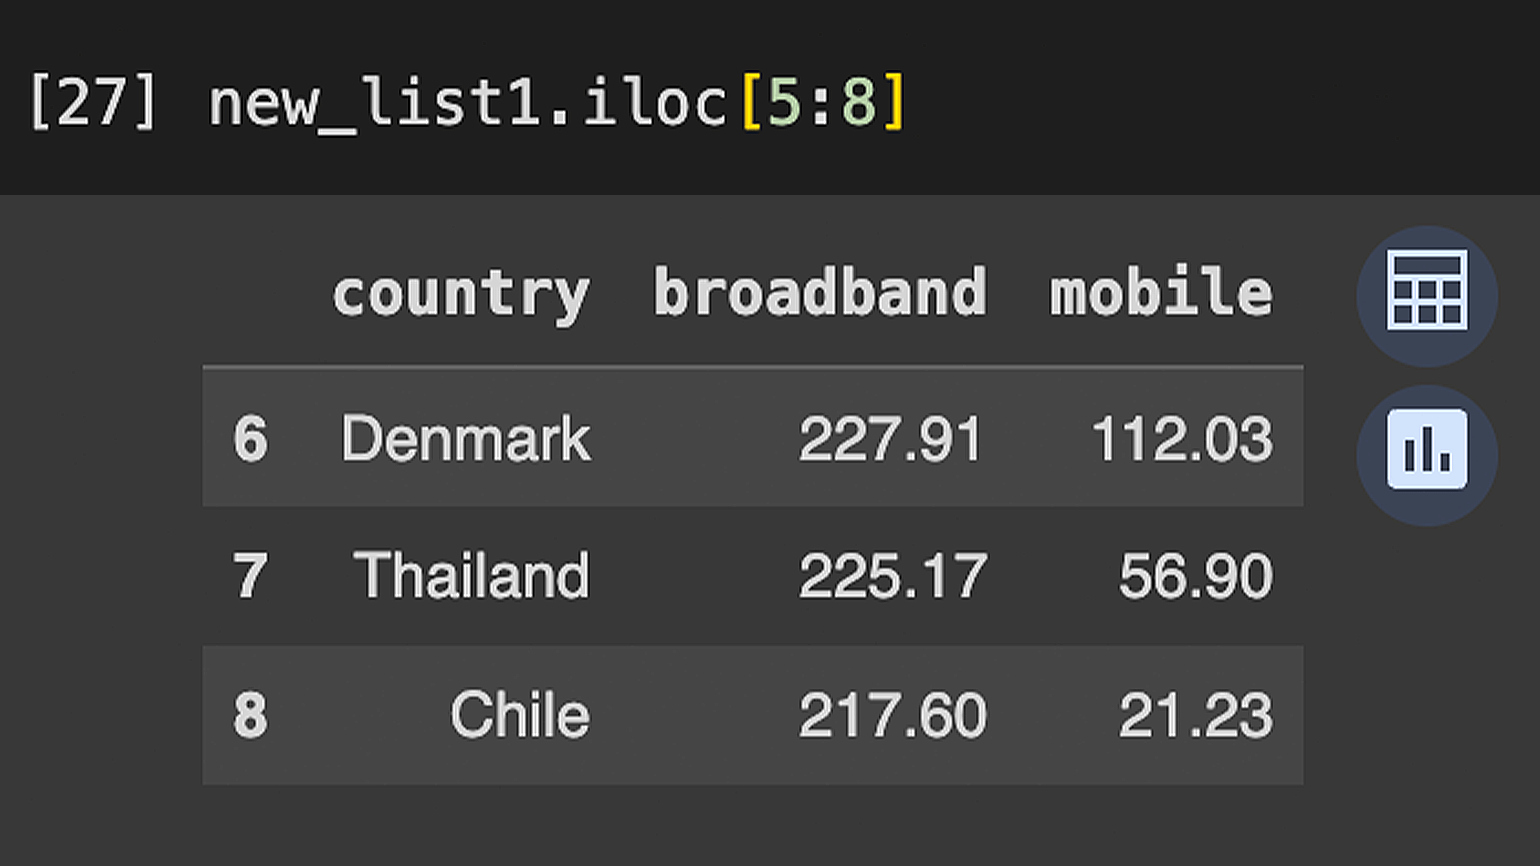
Получили срез списка с 6-го по 8-й объект. Обратите внимание, что индекс и индексные значения строк различаются.
Фильтрация датафрейма по значениям
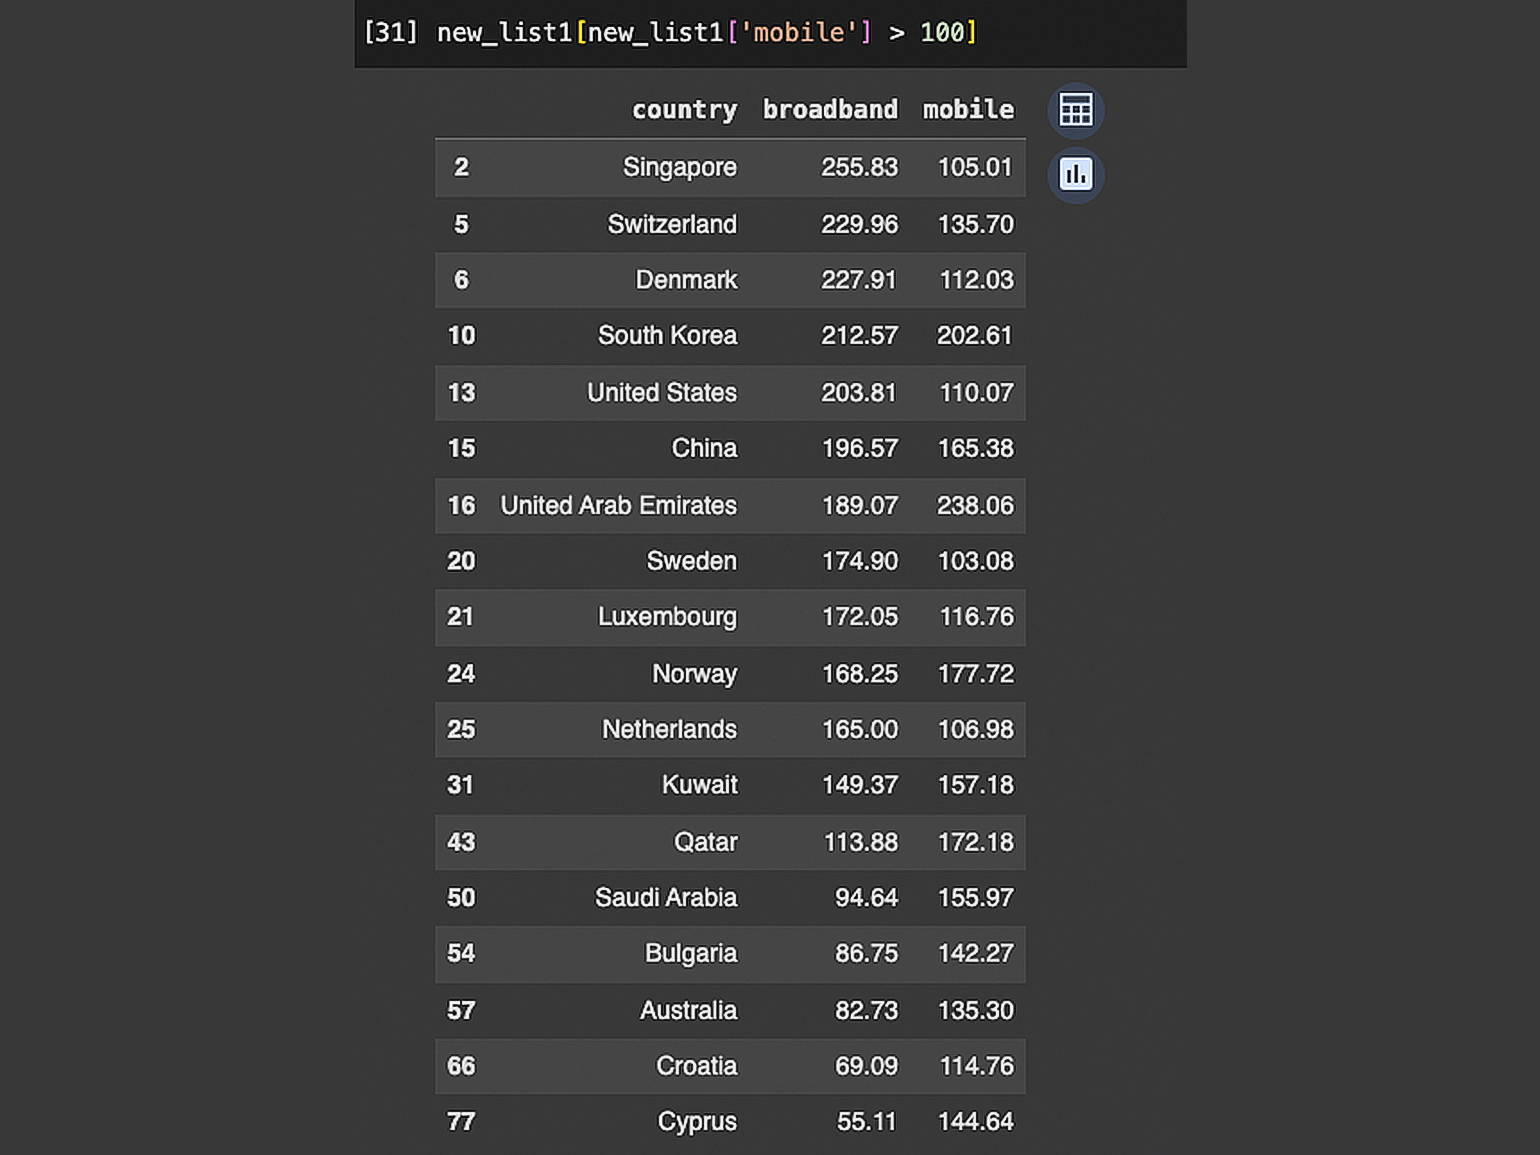
Выведем на экран только те страны, где скорость мобильного интернета более 100 Мбит/с:
Важно!
При использовании этого метода сохраняются индексные значения анализируемого датафрейма.
Агрегирование данных
Агрегирование данных — это функция, которая принимает несколько отдельных значений и возвращает сводные данные.
Рассчитаем среднее значение скорости интернета для всех стран с помощью функции agg, передав туда поле mean:
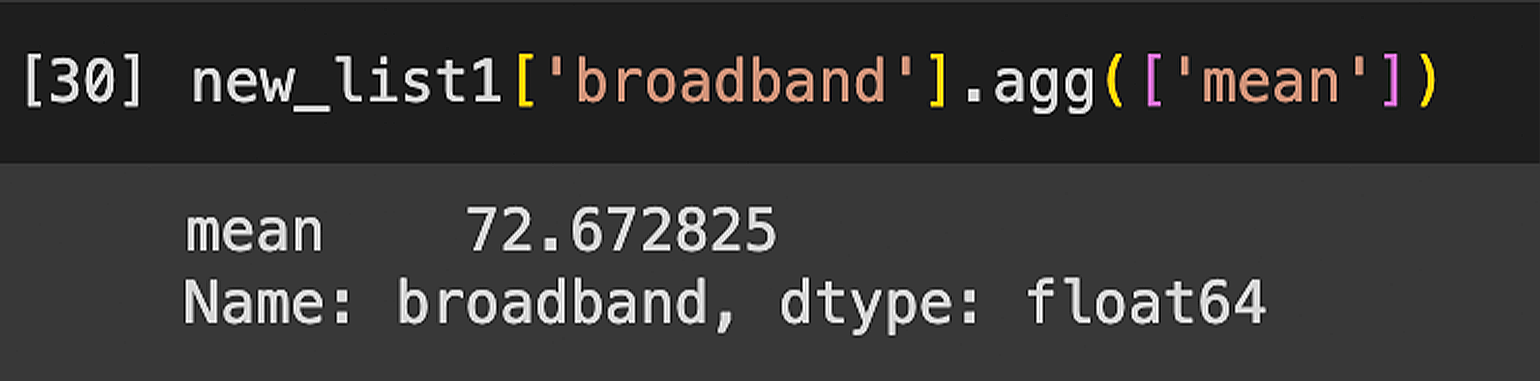
Среднее значение скорости интернета по всем странам — 72,67.
После завершения редактирования датафрейма его можно сохранить в CSV или другом формате:
new_list1.to_csv (r' C:\Users\Skillbox\Desktop\country.csv')
Сохранённый файл появится по указанному пути.
Что дальше?
Pandas в Python — мощная библиотека для анализа данных. В этой статье мы прошли по базовым операциям. Подробнее про работу библиотеки можно узнать в документации. Углубиться в работу с библиотекой можно благодаря специализированным книгам:
- «Изучаем pandas» Майкла Хейдта и Артёма Груздева;
- «Thinking in Pandas: How to Use the Python Data Analysis Library the Right Way», Hannah Stepanek;
- «Hands-On Data Analysis with Pandas: Efficiently perform data collection, wrangling, analysis, and visualization using Python», Stefanie Molin.
Читайте также:
- Библиотеки в программировании: для чего нужны и какими бывают
- Тест: угадайте, где эзотерические языки программирования, а где — нет
- Как начать программировать на Python: экспресс-гайд
Pandas: обзор библиотеки для Python
Библиотека Pandas входит в топ-5 самых востребованных навыков для вакансий в области data science.
Михаил Елизаров
Автор статьи
10 ноября 2022 в 18:26
Библиотека Pandas — «рабочая лошадка» аналитика данных. Она входит в топ-5 самых востребованных навыков для вакансий в области data science.
Рассказываем в статье, что такое Pandas для Python, как его установить, пользоваться и почему это классная штука.
Что такое Pandas для Python
Библиотеку используют для анализа и обработки табличных данных. Pandas — это как Excel, но мощнее. В Pandas можно спокойно работать с данными объемом в миллионы строк.
Поэтому на курсе Skypro «Аналитик данных» студентам дают основы Python. За несколько месяцев можно освоить базовые навыки, чтобы обрабатывать данные быстрее и качественнее. А еще с помощью знаний Python можно создавать визуализации, чтобы данные подтягивались туда из таблиц и обновлялись автоматически.
У Pandas открытый исходный код и подробная документация.
Структуры классов
Есть два главных класса библиотеки: Series и DataFrame.
Класс Series
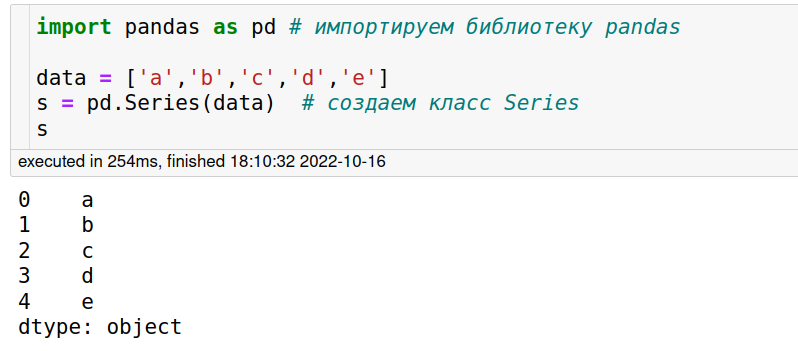
Series — одномерный индексированный массив, который способен хранить данные любого типа. Номер записи в массиве называется индексом.
Пример создания Series:
Класс DataFrame
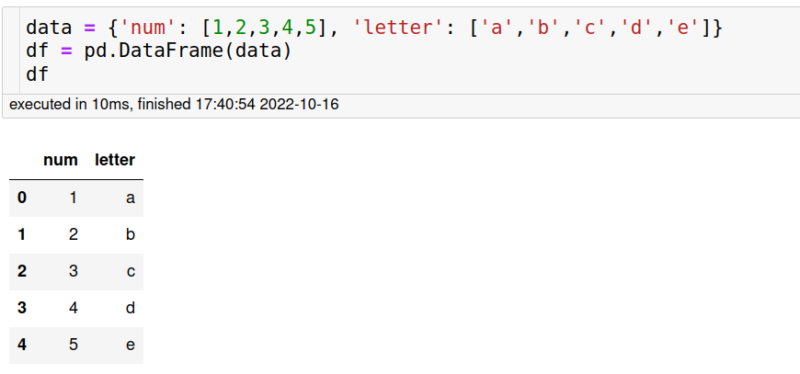
DataFrame — таблица с разными типами столбцов, то есть двумерная структура данных.
Пример создания DataFrame:
Как установить Pandas
Установите набор программ Anaconda — в него входит Python вместе с Pandas и другими полезными библиотеками.
- Скачайте установщик с сайта Anaconda.
- Откройте файл и следуйте инструкциям. Не забудьте поставить галочку в опции «Add Anaconda to my PATH environment variable».
- Перезагрузите компьютер.
- Откройте anaconda navigator и запустите jupyter notebook.
После этого импортируйте Pandas командой import pandas as pd.
Основная функциональность
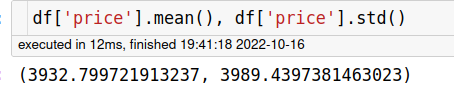
Методы классов Series и DataFrame позволяют считать сводные статистики: среднюю, медиану, сумму и другие.
Пример:
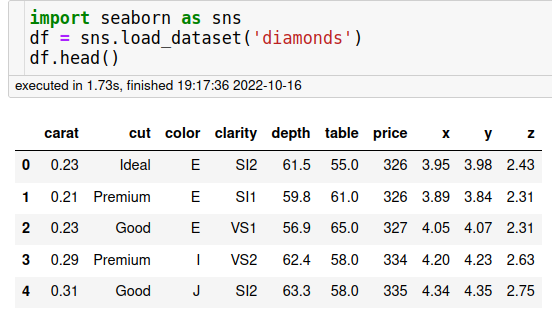
Загружаем данные с характеристиками алмазов.
Считаем среднее и стандартное отклонение цены.
Для статистик по категориям используйте группировку.
Пример:
Посмотрим средние значения цены и размеров по разным типам огранки из колонки cut.
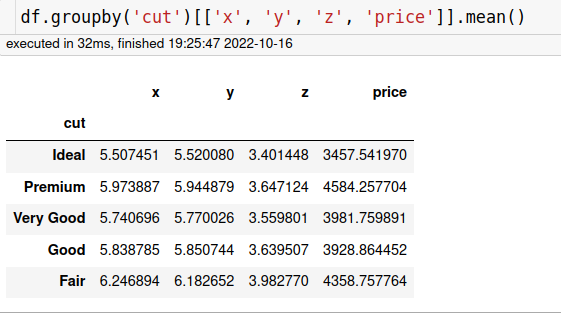
Обратите внимание, как отличается цена
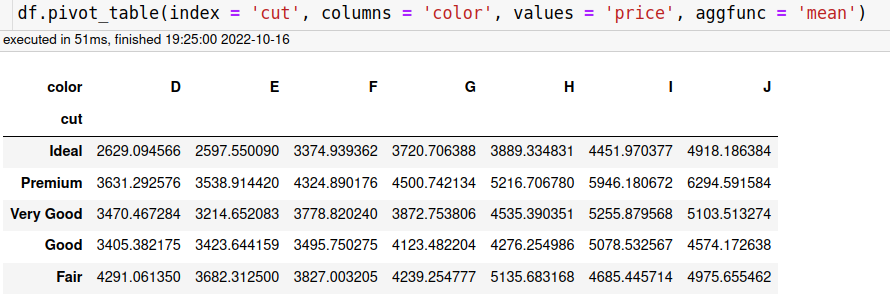
Для двух групп используйте сводные таблицы.
Пример:
Узнаем среднюю цену алмазов по качеству обработки и цвету.
При помощи Pandas можно визуализировать данные. Для создания графиков используйте метод plot с параметром kind, который отвечает за тип визуализации.
Некоторые виды графиков:
- линейный — вызывается по умолчанию;
- столбчатый;
- гистограмма;
- боксплот;
- диаграмма рассеяния.
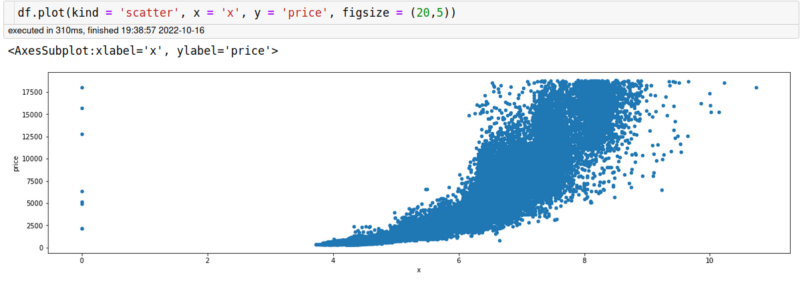
Посмотрим, как цена зависит от размера, построив диаграмму рассеяния.
Примеры использования в аналитике
Продолжим изучать данные об алмазах. Постараемся ответить на вопрос, что влияет на цену. Для работы понадобятся библиотеки Seaborn и Matplotlib, которые вы установили вместе с Anaconda.
Загрузим таблицу и посмотрим на ее начало, используя команду head.
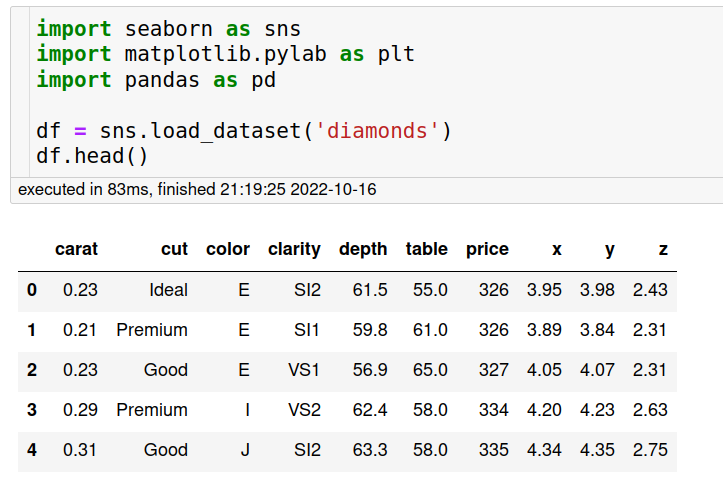
Shape показывает количество строк (53 940) и столбцов (10):
С помощью метода info посмотрим на типы данных и количество заполненных значений в колонках.
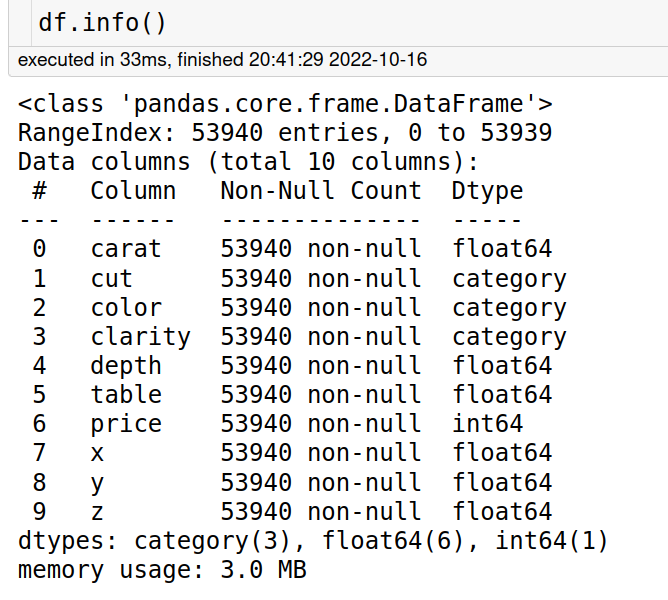
Сolor, cut и clarity — категориальные переменные. Остальные — вещественные (числа).
Проанализируем их по отдельности.
Анализ категориальных переменных
Посмотрим на уникальные значения по каждой колонке с помощью команды value_counts. Вызовем ее из цикла.
for i in ['cut', 'clarity', 'color']: print(df[i].value_counts())
Для визуализации используем боксплоты, которые показывают распределение цены по каждой из категорий.
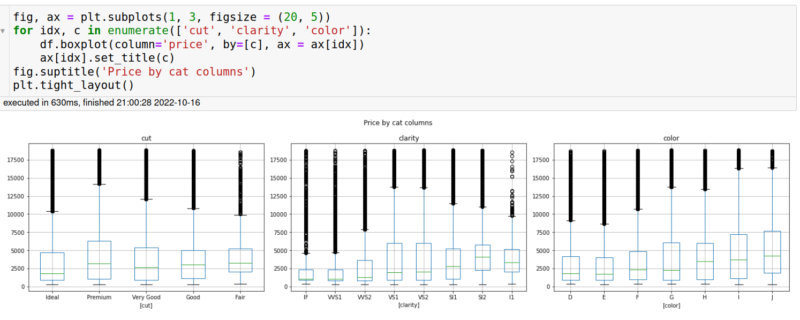
Вывод — исходя из графиков, дороже всего стоят алмазы с параметрами:
- Premium в колонке cut.
- VS1, VS2, SI1, SI2, I1 в колонке clarity.
- H, I или J в колонке color.
Анализ вещественных переменных
Статистику по числовым столбцам получим командой describe.
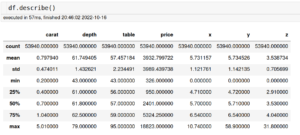
Посмотрим, как с ними взаимодействует стоимость камней, с помощью диаграмм рассеяния.
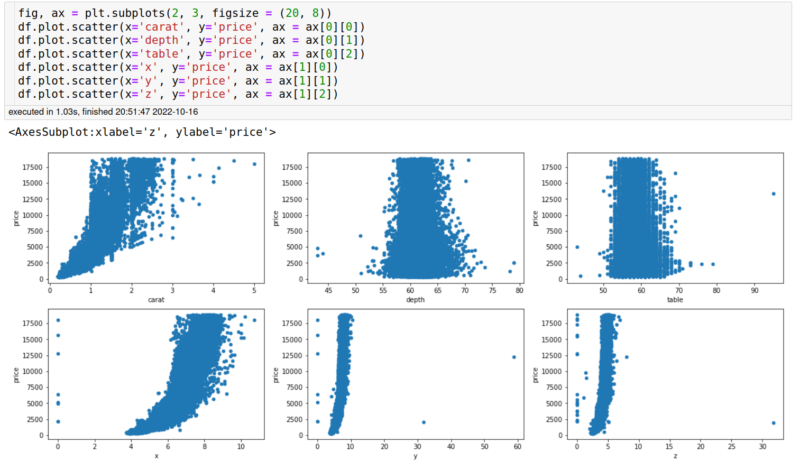
Вывод — цена сильнее всего зависит от переменных carat и x.
Мы узнали, что колонки carat, x, cut, clarity и color влияют на стоимость алмаза. Дальше можно построить модель для предсказания цены в зависимости от этих переменных.
Чтобы узнать, как это правильно сделать, записывайтесь на курс «Аналитик данных». За пять месяцев вы научитесь работать со статистикой, в Python, SQL и Excel. Наставники на курсе — аналитики из «Сбера», «Яндекса» и других крупных компаний. В конце курса специалисты центра карьеры помогут составить грамотное резюме и найти первую работу.
Краткие итоги
- Pandas — это библиотека Python для анализа таблиц.
- Чтобы пользоваться Pandas, установите Anaconda.
- Pandas позволяет группировать данные, генерировать сводные таблицы, вычислять статистики и рисовать графики.
- На примере датасета diamonds мы посмотрели, как использовать Pandas, чтобы понять, что влияет на цену алмазов.
- Научиться применять Pandas и Python можно на курсе «Аналитик данных».
Гайд по обработке данных с помощью Pandas: часть первая
Разбираем, как начать работу с Pandas. В этой части самые базовые приёмы: чтение и запись данных, индексирование, агрегация и другие основы.
Pandas — это библиотека на Python, предназначенная для обработки и анализа структурированных табличных данных. С её помощью можно фильтровать, сортировать, агрегировать и преобразовывать данные, а также интегрироваться с различными источниками для чтения и записи. Благодаря такому богатому функционалу, эффективности и удобству использования, Pandas — один из наиболее популярных инструментов в области анализа данных.
Руководитель группы видеоаналитики MTS AI Андрей Дугин рассказывает, как начать работу с Pandas и избежать распространённых ошибок.
Андрей Дугин
Руководитель группы видеоаналитики MTS AI
Где и для чего применяется Pandas
Pandas скорее академический исследовательский инструмент: для промышленных масштабов производительность у библиотеки относительно низкая, управление памятью не самое эффективное и нет параллелизма. Тем не менее, библиотека отлично подходит дата-сайентистам и аналитикам для прототипирования и исследования гипотез в нересурснозатратных проектах. Её можно применить практически в любой области, где требуется обработка и анализ табличных данных или временных рядов:
- Предиктивная аналитика для агрегаторов. Например, на сайтах недвижимости. Pandas поможет структурировать массив данных по квартирам: этаж, площадь, количество комнат, год постройки дома и так далее. На этих данных можно строить модели машинного обучения и предсказывать, сколько будет стоить недвижимость.
- Финансовый анализ. Pandas пригодится для анализа динамики цен акций, котировок валют, индексов и так далее. Это помогает при прогнозировании рыночных трендов, определении рисков и оценке инвестиционных стратегий.
- Маркетинговый анализ. Проанализировав с помощью Pandas данные о продажах, потребительском поведении, рекламных кампаниях можно определять оптимальные стратегии маркетинга.
- Исследования в области биоинформатики. Pandas помогает анализировать и обрабатывать биологические данные для выявления закономерностей, например, в болезнях.
- Обработка данных сенсоров и IoT. С помощью Pandas можно обрабатывать и анализировать данные сенсоров, полученных от устройств IoT, чтобы управлять системами, мониторить и диагностировать их.
Рассмотрим некоторые базовые приёмы работы с Pandas на основе классического датасета Titanic. Его используют студенты, изучающие машинное обучение, для предсказания шансов пассажиров на выживание в зависимости от их пола, возраста, класса каюты и других факторов. Подробнее почитать о значении полей можно в описании датасета на Kaggle.
Начало работы с Pandas
- Поскольку примеры кода и вывод выполняются в Jupyter Notebook, то для отображения результата нам не обязательно оборачивать выражения в функцию print() , однако это может понадобиться в других IDE.
- По этой же причине при демонстрации мы иногда не модифицируем исходные данные (не делаем присваивание A = B , а показываем только правую часть выражения; используем inplace=False ), а просто выводим результат.
Установка и импорт
Pandas легко установить через стандартный пакетный менеджер Python, используя команду pip install pandas .
После установки следует импортировать саму библиотеку. Поскольку Pandas строится на базе библиотеки NumPy — инструментария для работы с многомерными массивами — для удобства рекомендуется импортировать и её. Она также будет установлена автоматически в процессе установки Pandas.
import numpy as np import pandas as pd Структуры хранения данных
Данные организованы в структурированные таблицы с индексами, что облегчает манипуляции с ними. Операции в Pandas оптимизированы для работы по столбцам — так во многих случаях производительность выше, чем в операциях по строкам.
Структур хранения данных в Pandas две — Series и DataFrame.
- Series — это одномерный массив данных с метками. Он может хранить различные типы данных, включая числа, строки и произвольные объекты Python. Каждому элементу в Series соответствует метка, доступ к которой можно получить через атрибут index.
series = pd.Series([1, 2, 3], index=["a", "b", "c"], dtype=np.uint8) series Здесь и далее будет приводиться вывод в Jupyter Notebook
series.index Есть проводить аналогию со словарём dict , то индекс — это ключи словаря, а сам массив данных — значения, к которым можно получить доступ по ключу:
series["b"] # Получаем доступ по метке, как по ключу в словаре - DataFrame — это двумерная структура данных, представляющая собой таблицу с метками для строк и столбцов. Каждый столбец в DataFrame является объектом типа Series. Вместе они формируют двумерную таблицу с общим индексом. В DataFrame присутствуют две оси индексации: index для строк и columns для столбцов. Метки столбцов — это их названия.
dataframe = pd.DataFrame([[1, "Ivan", 5.0], [2, "Sergey", 4.3], [3, "Dmitry", 4.5]], columns=["#", "Name", "Score"]) dataframe dataframe["Name"] # Колонка — это объект Series dataframe["Name"].name # У объекта Series есть собственное имя Операции чтения и записи данных
С помощью Pandas можно читать и записывать данные из различных источников: баз данных, файлов в форматах CSV, Excel, JSON и тому подобных. Для каждого типа данных существуют специализированные функции: read_csv() , read_excel() и другие вида read_*() .
titanic = pd.read_csv("titanic.csv") titanic.head() Можно даже автоматически спарсить таблицу из веб-страницы, указав URL и порядковый номер таблицы:
from urllib.parse import quote url = quote("https://ru.wikipedia.org/wiki/Таблица", safe=":/") # Кодируем кириллицу pd.read_html(url)[0] # Берём первую таблицу из списка всех найденных на веб-странице Функции чтения принимают много параметров, так можно настраивать все необходимые опции, включая явное задание типов данных или соответствующих функций-конвертеров. Это позволяет предобработать данные или преобразовать их типы к более эффективным ещё на этапе чтения из источника.
Записать данные в файл так же просто, как и прочитать — используйте семейство методов .to_*() , например, .to_excel() :
titanic.to_excel("titanic.xlsx") Первичное исследование данных
После того как данные загружены из источника, следует получить общее представление о них.
Первые несколько строк датафрейма можно получить с помощью метода .head() , а последние — .tail() :
titanic.head(5) Тип данных object чаще всего соответствует строковым значениям:
titanic.dtypes Pandas позволяет автоматически подобрать наиболее эффективные представления с помощью метода .convert_dtypes() :
titanic.convert_dtypes().dtypes # Строковые значения теперь представлены типом string, а не object Другой способ взглянуть на датафрейм — метод .info() . Он показывает количество строк, столбцов, их названия и типы, а также позволяет обнаружить столбцы с отсутствующими значениями.
titanic.info() Например, в датасете 891 строка, однако количество ненулевых (non-null) значений в колонках Age, Cabin и Embarked меньше, значит, некоторые данные отсутствуют
Некоторую статистику по числовым столбцам можно собрать с помощью метода .describe() :
titanic.describe() Количество различных значений можно посчитать с помощью .value_counts() — как для категориальных, так и для непрерывных данных:
titanic["Survived"].value_counts(normalize=True) # Какой процент пассажиров выжил? titanic["Pclass"].value_counts(dropna=False) # Сколько пассажиров было в каждом классе? Индексирование
Операции обращения к элементам данных называются индексированием.
В нашем датасете индексная колонка по умолчанию представлена целыми числами. Для наглядности в дальнейших примерах заменим индекс на колонку с именем пассажира:
titanic.set_index("Name", inplace=True) # Производим изменения на месте — inplace titanic.head() Элементы индекса называются метками (лейблами):
titanic.index # Это вертикальный индекс; для списка используйте titanic.index.tolist() Названия колонок — тоже метки:
titanic.columns # Это горизонтальный индекс К колонкам можно обращаться по их названиям:
titanic["Ticket"] Если имя колонки удовлетворяет правилам именования переменных в Python и не совпадает с одним из уже существующих методов или атрибутов DataFrame, то к колонке можно обратиться как к атрибуту DataFrame:
titanic.Ticket; # То же самое, что titanic["Ticket"] Метод .loc[] есть и у Series, и у DataFrame. Он позволяет обращаться к данным по меткам:
titanic.loc["Heikkinen, Miss. Laina", "Ticket"] # Метод объекта DataFrame titanic["Ticket"].loc["Heikkinen, Miss. Laina"] # Метод объекта Series titanic.loc["Heikkinen, Miss. Laina", ["Ticket", "Age"]] # Можно выбрать несколько строк или колонок Метод .iloc[] работает аналогично, но вместо меток используются номера строк или столбцов:
titanic.iloc[2, 7] # Нумерация начинается с нуля titanic.iloc[0:3, 2:8] С помощью .at[] можно обратиться к конкретной ячейке данных — как в Excel:
titanic.at["Heikkinen, Miss. Laina", "Ticket"] При совершении операций над объектами DataFrame и Series Pandas пытается сопоставить элементы с одинаковыми индексами. Рассмотрим для примера последовательность Series с геометрической прогрессией, где каждый следующий элемент больше предыдущего в два раза:
series = pd.Series(2 ** np.arange(10)) series Попытка попарно посчитать отношение следующего элемента к предыдущему приведёт к «странному» результату:
series[1:] / series[:-1] На самом деле мы хотели получить следующее:
series[1:] / series[:-1].values # У массива .values уже нет индекса, и элементы сопоставляются просто последовательными парами Объединение данных
Для объединения нескольких датафреймов можно использовать близкие по смыслу функции: merge() , concat() и join() . Вот несколько базовых примеров:
df1 = pd.DataFrame() df1 df2 = pd.DataFrame() df2 pd.merge(df1, df2, on="key", how="inner") pd.concat([df1, df2], axis=0, ignore_index=True) df1.join(df2, how="inner", lsuffix="_1", rsuffix="_2") Агрегация данных
С помощью этих функций и методов можно взглянуть на данные в различных разрезах:
- groupby() — для группировки и агрегации данных с большой гибкостью;
- pivot_table() — для создания сводных таблиц с возможностью применения множественных агрегаций;
- crosstab() — для подсчёта частоты встречаемости категорий.
Рассчитаем средний возраст пассажиров с разбиением по полу:
titanic.groupby("Sex").Age.mean() Построим сводную таблицу, рассчитав вероятность выживания в зависимости от пола и класса:
pd.pivot_table(titanic, values="Survived", index="Sex", columns="Pclass", aggfunc="mean") Посчитаем, сколько человек каждого пола было в трёх классах кают:
pd.crosstab(titanic.Sex, titanic.Pclass) Групповые операции
При обработке данных новички часто используют циклы для итераций по строкам или ячейкам. Такой код выполняется медленно. Лучше использовать методы .apply() , .map() , .transform() , которые работают быстрее за счёт векторизации.
# Функция, которая в зависимости от возраста будет возвращать child/adult/senior def categorize_age(age): if age < 18: return"child" if age < 60: return"adult" else: return "senior" # Создадим новую колонку, применив нашу функцию к существующей titanic["Age_category"] = titanic["Age"].apply(categorize_age) titanic[["Age", "Age_category"]].head()Кстати, такое же разбиение на возрастные группы можно выполнить с помощью функции pd.cut() :
pd.cut(titanic.Age, bins=[0, 18, 60, titanic.Age.max()], labels=["child", "adult", "senior"]).head() Работа с пропущенными данными
В реальных датасетах часть данных может отсутствовать. В библиотеке Pandas эти пропуски обычно представлены как NaN (Not a Number) в ячейках DataFrame или Series. Чтобы с ними работать можно использовать ключевые методы:
- .isna() — идентифицирует отсутствующие значения и возвращает булевую маску, где True указывает на пропущенные данные;
- .fillna() — позволяет заполнить отсутствующие значения с помощью указанных значений или методов интерполяции;
- .dropna() — удаляет строки или столбцы, содержащие отсутствующие значения.
Метод .isna() есть как у DataFrame, так и у Series, а результатом его вызова будет булевая маска того же класса:
titanic.isna().head() titanic.loc[titanic.Age.isna()] # Найдём строки, в которых отсутствует возраст пассажира titanic.dropna(subset=["Age"], inplace=False) # Удалим строки, в которых отсутствует возраст пассажира Если датасет небольшой, то удалять отсутствующие данные слишком расточительно. Лучше придумать, как заполнить недостающие значения.
Например, можно заменить их средними значениями в столбце:
titanic.loc[titanic.Age.isna(), "Age"] = titanic.Age.mean() Или заполнить предыдущим, либо последующим значением:
titanic.Age.fillna(method="ffill", inplace=True) Методы генерации и заполнения отсутствующих значений называются импутингом. В библиотекеscikit-learnесть модульsklearn.impute, в котором представлены несколько классов импутеров, основанных на различных алгоритмах.
Визуализация данных
Pandas интегрирована с библиотекой Matplotlib — инструментом для создания двумерных и трёхмерных графических представлений данных. В Pandas можно либо явно использовать её функции для визуализации данных, либо применять встроенные методы, такие как .plot() и .hist() . Второй вариант облегчает построение графиков, автоматически определяя наилучший способ визуализации данных.
import matplotlib.pyplot as plt titanic.loc[titanic.Sex == "male", "Age"].hist(bins=10); То же самое можно сделать через прямой вызов функций matplotlib:
plt.hist(titanic[titanic.Sex == "male"].Age, bins=10); plt.grid(True) plt.title("Распределение пассажиров-мужчин по возрасту"); plt.xlabel("Возрастной диапазон"); plt.ylabel("Количество человек"); Работа с временными рядами
Индексная колонка датафрейма представлена датой и временем, что позволяет индексировать данные по дате и времени, ресемплировать (осуществлять выборку с большей или с меньшей частотой), интерполировать отсутствующие данные, применять оконные функции.
Допустим, у нас есть статистика перевозки пассажиров некой авиакомпании. Сгенерируем эти данные по месяцам:
# Сгенерируем диапазон дат с частотой 1 месяц date_rng = pd.date_range(start="1949-01-01", end="1960-12-01", freq="MS") # Создадим соответствующий датафрейм df = pd.DataFrame(date_rng, columns=["date"]) # Случайным образом сгенерируем колонку с числом пассажиров в каждом месяце df["passengers"] = np.random.randint(100, 500, size=len(date_rng)) # Сделаем колонку с датами индексной df.set_index("date", inplace=True) df.head() А теперь рассчитаем среднемесячное количество пассажиров по каждому году:
df_downsampled = df.resample("A").mean() plt.figure(figsize=(10, 6)) plt.plot(df.index, df["passengers"], label="Исходные данные") plt.plot(df_downsampled.index, df_downsampled["passengers"], label="Среднее по годам", linestyle="--") plt.xlabel("Год") plt.ylabel("Количество пассажиров") plt.grid(True) plt.legend() plt.show() Применим скользящее окно и рассчитаем среднее количество пассажиров за последние 12 месяцев:
df_rolled = df.rolling(12).mean() df_rolled.head(15) В первых 11 строках по умолчанию появились значения NaN, так как количество проанализированных строк меньше размера окна. Это поведение можно изменить, задав параметр min_periods — минимальное количество строк, для которых определён результат:
df.rolling(12, min_periods=1).mean().head() В заключение
В этой части статьи мы рассмотрели, как использовать Pandas для разных базовых задач. Во второй части разберём, как сделать работу с Pandas эффективнее, узнаем, какие есть альтернативы для этой библиотеки и какие источники можно почитать, чтобы ещё лучше в ней ориентироваться. Следите за обновлениями!