Функция COUNT (Transact-SQL)
Эта функция возвращает количество элементов, найденных в группе. Функция COUNT работает подобно функции COUNT_BIG. Эти функции различаются только типами данных в возвращаемых значениях. Функция COUNT всегда возвращает значение типа данных int. Функция COUNT_BIG всегда возвращает значение типа данных bigint.
Синтаксис
Синтаксис функции агрегирования
COUNT ( < [ [ ALL | DISTINCT ] expression ] | * >) Синтаксис функции аналитики
COUNT ( [ ALL ] < expression | * >) OVER ( [ ] ) Сведения о синтаксисе Transact-SQL для SQL Server 2014 (12.x) и более ранних версиях см . в документации по предыдущим версиям.
Аргументы
ВСЕ
Применяет агрегатную функцию ко всем значениям. Аргумент ALL используется по умолчанию.
DISTINCT
Указывает, что функция COUNT возвращает количество уникальных значений, не равных NULL.
выражение
Выражение любого типа, кромеimage, ntext и text. COUNT не поддерживает агрегатные функции или вложенные запросы в выражении.
Указывает, что функция COUNT должна учитывать все строки, чтобы определить общее количество строк таблицы для возврата. COUNT(*) не принимает параметров и не поддерживает использование DISTINCT. COUNT(*) не требует параметра выражения, так как по определению он не использует сведения о определенном столбце. Функция COUNT(*) возвращает количество строк в указанной таблице с учетом повторяющихся строк. Она подсчитывает каждую строку отдельно. При этом учитываются и строки, содержащие значения NULL.
OVER ( [ partition_by_clause ] [ order_by_clause ] [ ROW_or_RANGE_clause ] )
partition_by_clause делит результирующий набор, полученный с помощью предложения FROM , на секции, к которым применяется функция COUNT . Если этот параметр не указан, функция обрабатывает все строки результирующего набора запроса как отдельные группы. order_by_clause определяет логический порядок выполнения операции. Дополнительные сведения см . в предложении OVER (Transact-SQL ).
Типы возвращаемых данных
- int NOT NULL , ANSI_WARNINGS если имеет значение ON , однако SQL Server всегда будет обрабатывать COUNT выражения как int NULL в метаданных, если только не упакованы в ISNULL .
- int NULL , если ANSI_WARNINGS имеет значение OFF .
Замечания
- COUNT(*) без GROUP BY возврата карта inality (количество строк) в наборе результатов. К ним относятся строки, состоящие из всех NULL значений и дубликатов.
- COUNT(*) при GROUP BY возврате числа строк в каждой группе. Сюда входят NULL значения и дубликаты.
- COUNT(ALL ) вычисляет выражение для каждой строки в группе и возвращает количество ненулевого значения.
- COUNT(DISTINCT *expression*) вычисляет выражение для каждой строки в группе и возвращает количество уникальных, ненулевого значения.
COUNT — это детерминированная функция, если она используется без предложений OVER и ORDER BY. Она не детерминирована при использовании с предложениями OVER и ORDER BY. Дополнительные сведения см. в разделе детерминированные и недетерминированные функции.
ARITHABORT и ANSI_WARNINGS .
Если COUNT имеет возвращаемое значение, превышающее максимальное значение int (то есть 2 31-1 или 2 147 483 647), COUNT функция завершится ошибкой из-за целочисленного переполнения. При COUNT переполнении и параметрах ARITHABORT OFF COUNT ANSI_WARNINGS возвращается. NULL В противном случае, если или есть, ANSI_WARNINGS ARITHABORT ON запрос будет прерваться, и будет вызвана ошибка арифметического переполнения. Msg 8115, Level 16, State 2; Arithmetic overflow error converting expression to data type int. Чтобы правильно обрабатывать эти большие результаты, используйте COUNT_BIG вместо этого, что возвращает bigint.
Если оба ARITHABORT и ANSI_WARNINGS есть ON , вы можете безопасно упаковать COUNT сайты вызовов, ISNULL( , 0 ) чтобы принудить тип выражения вместо int NOT NULL int NULL . Упаковка COUNT в ISNULL означает, что любая ошибка переполнения будет автоматически подавляться, что должно быть рассмотрено для правильности.
Примеры
А. Использование COUNT и DISTINCT
В этом примере возвращается количество различных названий, которые может хранить сотрудник Adventure Works Cycles.
SELECT COUNT(DISTINCT Title) FROM HumanResources.Employee; GO ----------- 67 (1 row(s) affected) B. Использование COUNT(*)
В этом примере возвращается общее количество сотрудников Adventure Works Cycles.
SELECT COUNT(*) FROM HumanResources.Employee; GO ----------- 290 (1 row(s) affected) C. Использование COUNT(*) с другими агрегатами
В этом примере показано, что функция COUNT(*) работает с другими статистическими функциями в списке SELECT . В примере используется база данных AdventureWorks2022.
SELECT COUNT(*), AVG(Bonus) FROM Sales.SalesPerson WHERE SalesQuota > 25000; GO ----------- --------------------- 14 3472.1428 (1 row(s) affected) D. Использование предложения OVER
В этом примере используются MAX AVG MIN функции и COUNT функции с OVER предложением для возврата агрегированных значений для каждого отдела в таблице базы данных HumanResources.Department AdventureWorks2022.
SELECT DISTINCT Name , MIN(Rate) OVER (PARTITION BY edh.DepartmentID) AS MinSalary , MAX(Rate) OVER (PARTITION BY edh.DepartmentID) AS MaxSalary , AVG(Rate) OVER (PARTITION BY edh.DepartmentID) AS AvgSalary , COUNT(edh.BusinessEntityID) OVER (PARTITION BY edh.DepartmentID) AS EmployeesPerDept FROM HumanResources.EmployeePayHistory AS eph JOIN HumanResources.EmployeeDepartmentHistory AS edh ON eph.BusinessEntityID = edh.BusinessEntityID JOIN HumanResources.Department AS d ON d.DepartmentID = edh.DepartmentID WHERE edh.EndDate IS NULL ORDER BY Name; Name MinSalary MaxSalary AvgSalary EmployeesPerDept ----------------------------- --------------------- --------------------- --------------------- ---------------- Document Control 10.25 17.7885 14.3884 5 Engineering 32.6923 63.4615 40.1442 6 Executive 39.06 125.50 68.3034 4 Facilities and Maintenance 9.25 24.0385 13.0316 7 Finance 13.4615 43.2692 23.935 10 Human Resources 13.9423 27.1394 18.0248 6 Information Services 27.4038 50.4808 34.1586 10 Marketing 13.4615 37.50 18.4318 11 Production 6.50 84.1346 13.5537 195 Production Control 8.62 24.5192 16.7746 8 Purchasing 9.86 30.00 18.0202 14 Quality Assurance 10.5769 28.8462 15.4647 6 Research and Development 40.8654 50.4808 43.6731 4 Sales 23.0769 72.1154 29.9719 18 Shipping and Receiving 9.00 19.2308 10.8718 6 Tool Design 8.62 29.8462 23.5054 6 (16 row(s) affected) Примеры: Azure Synapse Analytics и система платформы аналитики (PDW)
Д. Использование COUNT и DISTINCT
В этом примере функция возвращает количество различных должностей, которые может иметь конкретный сотрудник компании.
USE ssawPDW; SELECT COUNT(DISTINCT Title) FROM dbo.DimEmployee; F. Использование COUNT(*)
В этом примере функция возвращает общее количество строк в таблице dbo.DimEmployee .
USE ssawPDW; SELECT COUNT(*) FROM dbo.DimEmployee; G. Использование COUNT(*) с другими агрегатами
В этом примере функция COUNT(*) работает с другими статистическими функциями в списке SELECT . Запрос возвращает количество торговых представителей с годовой квотой продаж более 500 000 долл. США и их среднюю квоту продаж.
USE ssawPDW; SELECT COUNT(EmployeeKey) AS TotalCount, AVG(SalesAmountQuota) AS [Average Sales Quota] FROM dbo.FactSalesQuota WHERE SalesAmountQuota > 500000 AND CalendarYear = 2001; TotalCount Average Sales Quota ---------- ------------------- 10 683800.0000 H. Использование COUNT с ПОМОЩЬЮ HAVING
В этом примере функция COUNT используется с предложением HAVING , чтобы получить список подразделений компании, в каждом из которых работает более 15 сотрудников.
USE ssawPDW; SELECT DepartmentName, COUNT(EmployeeKey)AS EmployeesInDept FROM dbo.DimEmployee GROUP BY DepartmentName HAVING COUNT(EmployeeKey) > 15; DepartmentName EmployeesInDept -------------- --------------- Sales 18 Production 179 I. Использование COUNT с OVER
В этом примере функция COUNT используется с предложением OVER , чтобы получить количество продуктов, содержащихся в каждом из указанных заказов на продажу.
USE ssawPDW; SELECT DISTINCT COUNT(ProductKey) OVER(PARTITION BY SalesOrderNumber) AS ProductCount , SalesOrderNumber FROM dbo.FactInternetSales WHERE SalesOrderNumber IN (N'SO53115',N'SO55981'); ProductCount SalesOrderID ------------ ----------------- 3 SO53115 1 SO55981 См. также
- Агрегатные функции (Transact-SQL)
- COUNT_BIG (Transact-SQL)
- Предложение OVER (Transact-SQL)
Подсчет количества уникальных значений
С помощью оператора GROUP BY вы группируете результаты выборки по столбцу c.Country, а агрегатная функция COUNT выводит количество строк каждой группы.
SELECT c.Country, COUNT(*) FROM Customers c INNER JOIN Orders o ON c.CustomerID = o.CustomerID GROUP BY c.Country ORDER BY c.Country Отслеживать
ответ дан 14 мар 2018 в 11:52
Mursalov Oleg Mursalov Oleg
169 7 7 бронзовых знаков
Спасибо. Итоговый вид запроса: SELECT c.Country, COUNT(*) as var FROM Customers c INNER JOIN Orders o ON c.CustomerID = o.CustomerID GROUP BY c.Country ORDER BY var Desc LIMIT 5
Запросы
С помощью оператора DISTINCT можно выбрать уникальные данные по определенным столбцам.
К примеру, разные товары могут иметь одних и тех же производителей, и, допустим, у нас следующая таблица товаров:
USE productsdb; DROP TABLE IF EXISTS Products; CREATE TABLE Products ( Id INT AUTO_INCREMENT PRIMARY KEY, ProductName VARCHAR(30) NOT NULL, Manufacturer VARCHAR(20) NOT NULL, ProductCount INT DEFAULT 0, Price DECIMAL NOT NULL ); INSERT INTO Products (ProductName, Manufacturer, ProductCount, Price) VALUES ('iPhone X', 'Apple', 3, 71000), ('iPhone 8', 'Apple', 3, 56000), ('Galaxy S9', 'Samsung', 6, 56000), ('Galaxy S8', 'Samsung', 2, 46000), ('Honor 10', 'Huawei', 3, 26000);
Выберем всех производителей:
SELECT Manufacturer FROM Products;
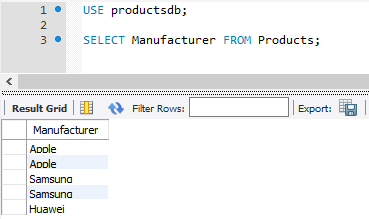
Однако при таком запросе производители повторяются. Теперь применим оператор DISTINCT для выборки уникальных значений:
SELECT DISTINCT Manufacturer FROM Products;
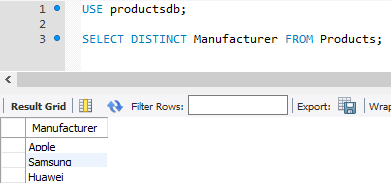
Также мы можем задавать выборку уникальных значений по нескольким столбцам:
SELECT DISTINCT Manufacturer, ProductCount FROM Products;
В данном случае для выборки используются столбцы Manufacturer и ProductCount. Из пяти строк только для двух строк эти столбцы имеют повторяющиеся значения. Поэтому в выборке будет 4 строки:
COUNT DISTINCT в SQL: Подсчет уникальных значений в базе данных
Запрос SQL для подсчета уникальных значений в столбце таблицы:
SELECT COUNT(DISTINCT columnName) FROM tableName;
где «columnName» — это имя столбца, в котором нужно подсчитать уникальные значения, а «tableName» — таблица, содержащая данный столбец.
Для таблицы «users» с полями «id», «name», «email» и «age» мы можем использовать следующий запрос для подсчета количества уникальных email-адресов:
SELECT COUNT(DISTINCT email) FROM users;
Аналогично, для таблицы «orders» с полями «order_id», «customer_id», «product_id» и «price» запрос может выглядеть так:
SELECT COUNT(DISTINCT customer_id) FROM orders;
Также можно использовать несколько столбцов для подсчета количества уникальных комбинаций значений. Например, для таблицы «sales» с полями «date», «product_id», «quantity» и «price» мы можем использовать запрос:
SELECT COUNT(DISTINCT date, product_id) FROM sales;
Этот запрос покажет число уникальных дат и продуктов, проданных в таблице «sales».
Таким образом, функция «COUNT(DISTINCT)» в SQL позволяет подсчитывать количество уникальных значений в столбцах таблицы и может быть использована в различных контекстах для анализа данных.